一 无向图
1.1 无向图定义
- 相邻顶点
- 当两个顶点通过一条边相连时,我们称这两个顶点是相邻的,并且称这条边依附于这两个顶点。
- 度
- 某个顶点的度就是依附于该顶点的边的个数
- 子图
- ·是一幅图的所有边的子集(包含这些边依附的顶点)组成的图;
- 路径
- 是由边顺序连接的一系列的顶点组成
- 环
- 是一条至少含有一条边且终点和起点相同的路径
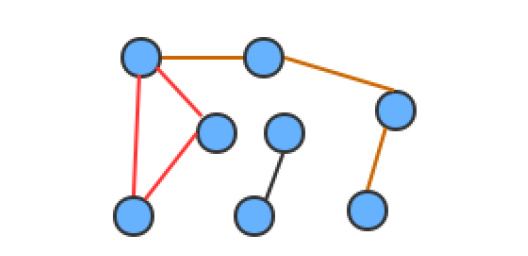
- 连通
- 如果图中任意一个顶点都存在一条路径到达另外一个顶点,那么这幅图就称之为连通图
- 连通子图
- 使用一个V*V的二维数组int[V][V] adj,把索引的值看做是顶点;
2. 如果顶点v和顶点w相连,我们只需要将adj[v][w]和adj[w][v]的值设置为1,否则设置为0即可。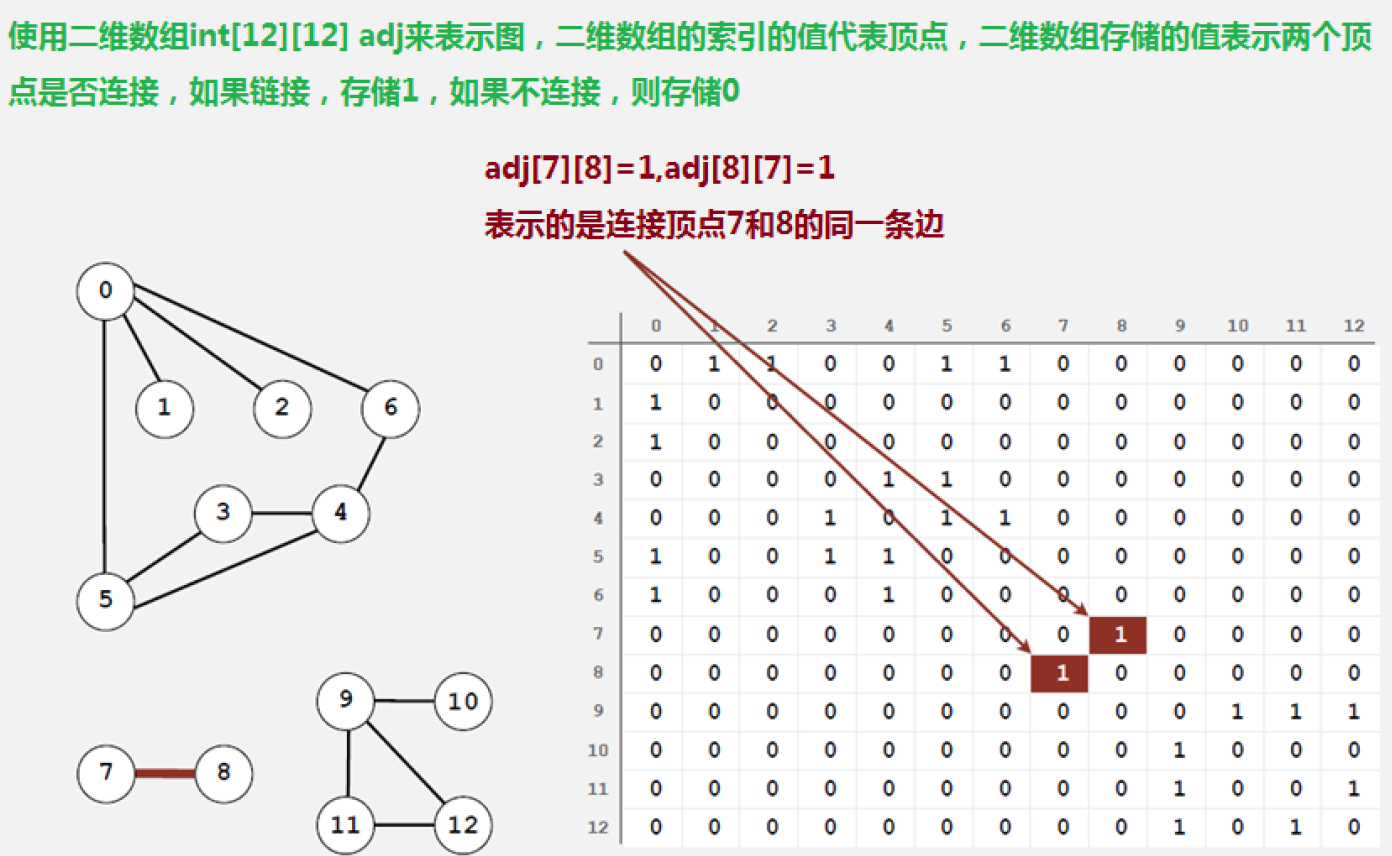
很明显,邻接矩阵这种存储方式的空间复杂度是V^2的,如果我们处理的问题规模比较大的话,内存空间极有可能不够用。1.2.2 邻接表
1.使用一个大小为V的数组 Queue[V] adj,把索引看做是顶点;
2.每个索引处adj[v]存储了一个队列,该队列中存储的是所有与该顶点相邻的其他顶点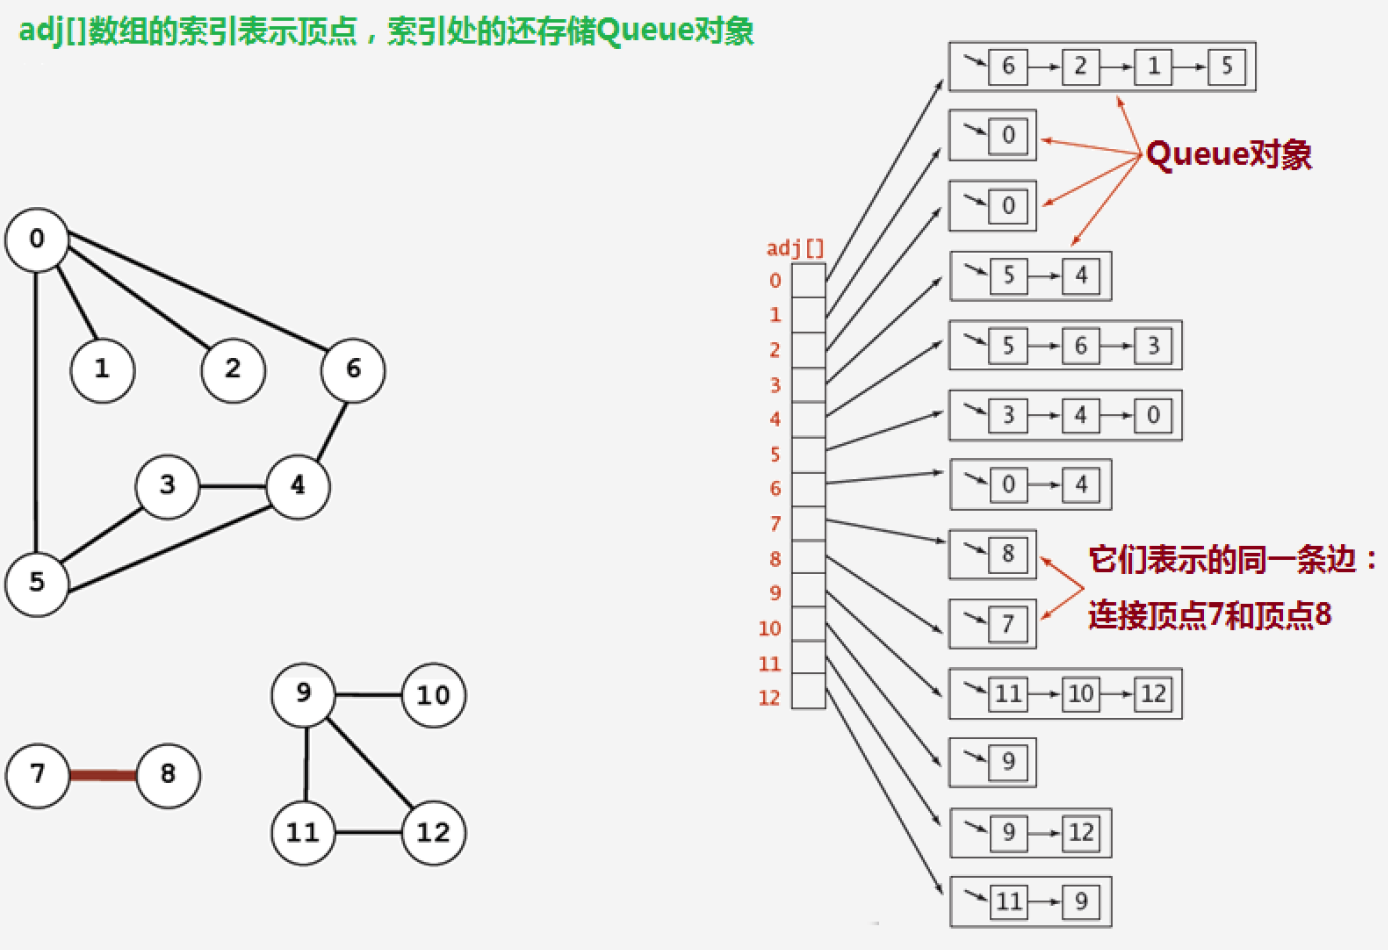
很明显,邻接表的空间并不是是线性级别的,所以后面我们一直采用邻接表这种存储形式来表示图。1.3 无向图代码
```java package com.ycc.data.structure.graph;

import com.ycc.data.structure.line.MyArrayQueue;
/**
- 无向图 *
- @author hezhaoming
@date 2020/9/19 */ public class Graph { //顶点数目 private final int V; //边的数目 private int E; //邻接表 private MyArrayQueue
[] adj; public Graph(int V) {
//初始化顶点数量this.V = V;//初始化边的数量this.E = 0;//初始化邻接表this.adj = new MyArrayQueue[V];for (int i = 0; i < adj.length; i++) {adj[i] = new MyArrayQueue<>();}
}
//获取顶点数目 public int V() {
return V;}
//获取边的数目 public int E() {
return E;}
//向图中添加一条边 顶点v-顶点w public void addEdge(int v, int w) {
 //在无向图中,边是没有方向的,所以该边既可以说是从v到w的边,又可以说是从w到v的边,因此,需要让w出现在v的邻接表中,并且还要让v出现在w的邻接表中
 adj[v].enQueue(w);
 adj[w].enQueue(v);
 //边的数量+1
 E++;
}
//获取和顶点v相邻的所有顶点 public MyArrayQueue
adj(int v) { //返回v所对应的邻接表即可 return adj[v];}
}
<a name="i4up4"></a>
## 1.4 深度搜索
所谓的深度优先搜索,指的是在搜索时,如果遇到一个结点既有子结点,又有兄弟结点,那么先找子结点,然后找兄弟结点。例如 0-->6-->4-->5-->3
<a name="CIBtz"></a>
### 1.4.1 实现原理
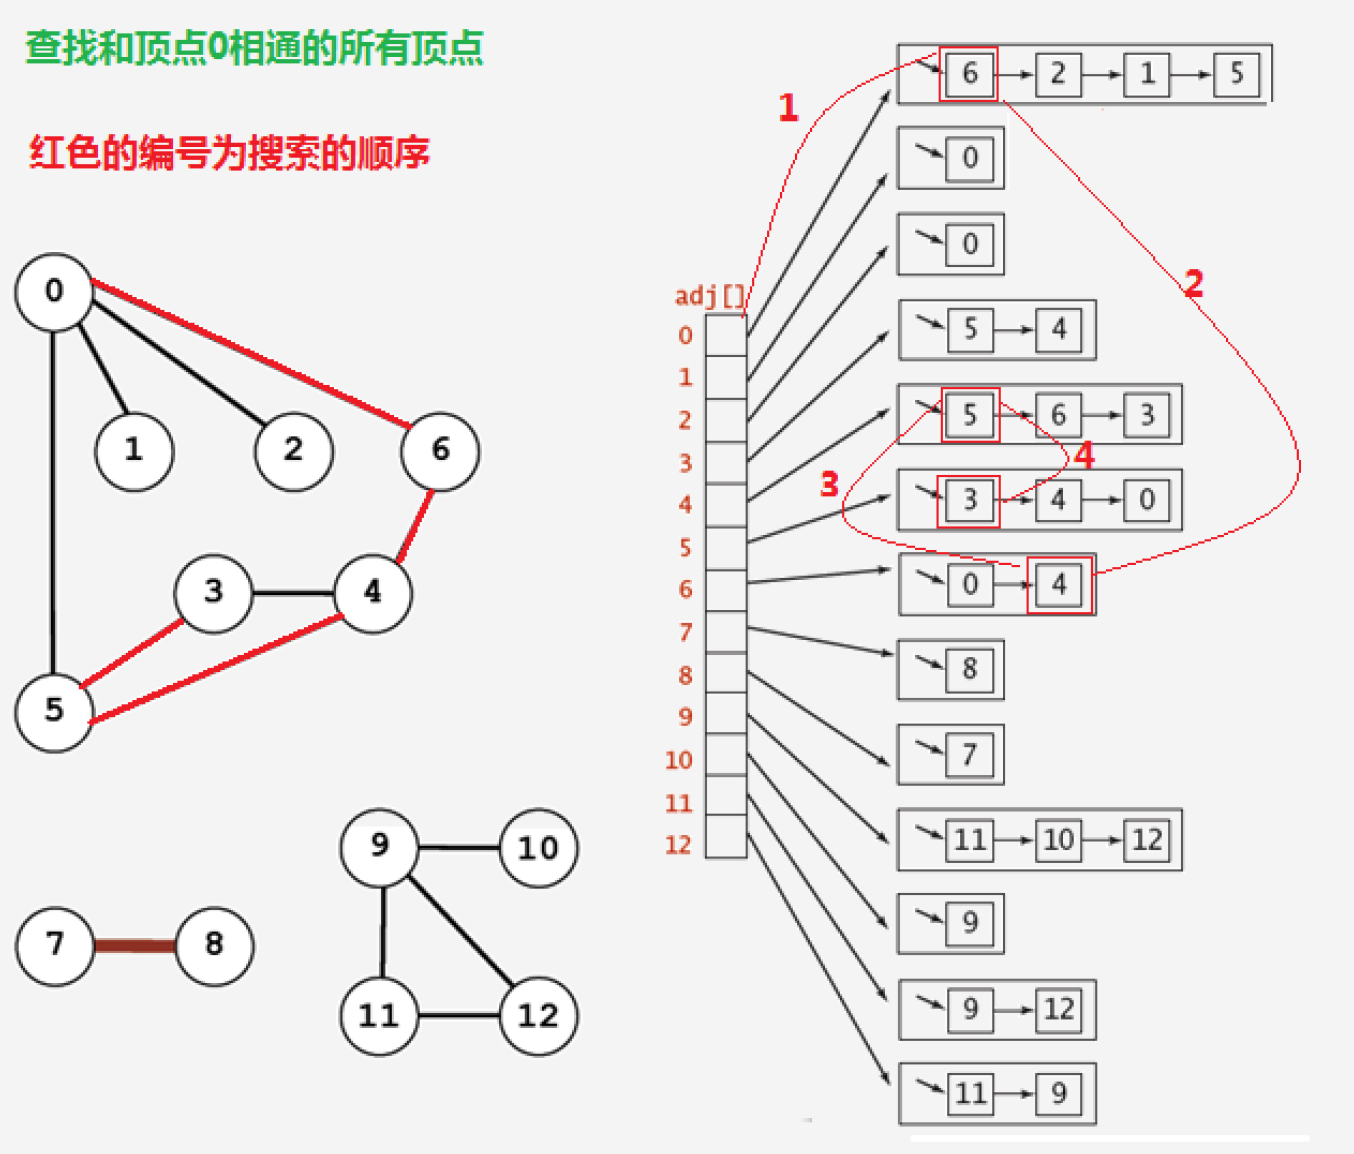<br />很明显,在由于边是没有方向的,所以,如果4和5顶点相连,那么4会出现在5的相邻链表中,5也会出现在4的相邻链表中,那么为了不对顶点进行重复搜索,应该要有相应的标记来表示当前顶点有没有搜索过,可以使用一个布尔类型的数组 boolean[V] marked,索引代表顶点,值代表当前顶点是否已经搜索,如果已经搜索,标记为true,如果没有搜索,标记为false;
<a name="F2OBi"></a>
### 1.4.2 代码实现
```java
package com.ycc.data.structure.graph;
import cn.itcast.algorithm.graph.Graph;
/**
* 深度优先
* @author hezhaoming
* @date 2020/9/19
*/
public class DepthFirstSearch {
//索引代表顶点,值表示当前顶点是否已经被搜索
private boolean[] marked;
//记录有多少个顶点与s顶点相通
private int count;
//构造深度优先搜索对象,使用深度优先搜索找出G图中s顶点的所有相邻顶点
public DepthFirstSearch(cn.itcast.algorithm.graph.Graph G, int s) {
//初始化marked数组
this.marked = new boolean[G.V()];
//初始化跟顶点s相通的顶点的数量
this.count = 0;
dfs(G, s);
}
//使用深度优先搜索找出G图中v顶点的所有相通顶点
private void dfs(Graph G, int v) {
//把v顶点标识为已搜索
marked[v] = true;
for (Integer w : G.adj(v)) {
//判断当前w顶点有没有被搜索过,如果没有被搜索过,则递归调用dfs方法进行深度搜索
if (!marked[w]) {
dfs(G, w);
}
}
//相通顶点数量+1
count++;
}
//判断w顶点与s顶点是否相通
public boolean marked(int w) {
return marked[w];
}
//获取与顶点s相通的所有顶点的总数
public int count() {
return count;
}
}
1.4.3 测试代码
package com.ycc.data.structure.graph.test;

import cn.itcast.algorithm.graph.DepthFirstSearch;
import cn.itcast.algorithm.graph.Graph;

public class DepthFirstSearchTest {

    public static void main(String[] args) {

        //准备Graph对象
        Graph G = new Graph(13);
        G.addEdge(0,5);
        G.addEdge(0,1);
        G.addEdge(0,2);
        G.addEdge(0,6);

        G.addEdge(5,3);
        G.addEdge(5,4);

        G.addEdge(3,4);
        G.addEdge(4,6);

        G.addEdge(7,8);

        G.addEdge(9,11);
        G.addEdge(9,10);
        G.addEdge(9,12);

        G.addEdge(11,12);

        //准备深度优先搜索对象
        DepthFirstSearch search = new DepthFirstSearch(G, 0);

        //测试与某个顶点相通的顶点数量
        int count = search.count();
        System.out.println("与起点0相通的顶点的数量为:"+count);


        //测试某个顶点与起点是否相同
        boolean marked1 = search.marked(5);
        System.out.println("顶点5和顶点0是否相通:"+marked1);


        boolean marked2 = search.marked(7);
        System.out.println("顶点7和顶点0是否相通:"+marked2);

    }
}
1.5 广度搜索
所谓的深度优先搜索,指的是在搜索时,如果遇到一个结点既有子结点,又有兄弟结点,那么先找兄弟结点,然后找子结点。
1.5.1 实现原理

1.5.2 代码实现
package com.ycc.data.structure.graph;

import com.ycc.data.structure.line.MyArrayQueue;

/**
 * 广度优先
 *
 * @author hezhaoming
 * @date 2020/9/19
 */
public class BreadthFirstSearch {
    //索引代表顶点,值表示当前顶点是否已经被搜索
    private final boolean[] marked;
    //记录有多少个顶点与s顶点相通
    private int count;
    //用来存储待搜索邻接表的点
    private final MyArrayQueue<Integer> waitSearch;

    //构造广度优先搜索对象,使用广度优先搜索找出G图中s顶点的所有相邻顶点
    public BreadthFirstSearch(Graph G, int s) {
        this.marked = new boolean[G.V()];
        this.count = 0;
        this.waitSearch = new MyArrayQueue<Integer>();
        bfs(G, s);
    }

    //使用广度优先搜索找出G图中v顶点的所有相邻顶点
    private void bfs(Graph G, int v) {
        //把当前顶点v标识为已搜索
        marked[v] = true;
        //让顶点v进入队列,待搜索
        waitSearch.enQueue(v);
        //通过循环,如果队列不为空,则从队列中弹出一个待搜索的顶点进行搜索
        while (!waitSearch.isEmpty()) {
            //弹出一个待搜索的顶点
            Integer wait = waitSearch.deQueue();
            MyArrayQueue queue = G.adj(wait);
            //遍历wait顶点的邻接表
            for (int i = 0; i < queue.length(); i++) {
                Integer integer = (Integer) queue.get(i);
                if (!marked[integer]) {
                    //如果没有被搜索则递归调用搜索
                    bfs(G, integer);
                }
            }
        }
        //让相通的顶点+1;
        count++;

    }

    //判断w顶点与s顶点是否相通
    public boolean marked(int w) {
        return marked[w];
    }

    //获取与顶点s相通的所有顶点的总数
    public int count() {
        return count;
    }
}
1.5.3 测试代码
package com.ycc.data.structure.graph.test;


import com.ycc.data.structure.graph.BreadthFirstSearch;
import com.ycc.data.structure.graph.Graph;

public class BreadthFirstSearchTest {

    public static void main(String[] args) {

        //准备Graph对象
        Graph G = new Graph(13);

        G.addEdge(0, 5);
        G.addEdge(0, 1);
        G.addEdge(0, 2);
        G.addEdge(0, 6);

        G.addEdge(5, 3);
        G.addEdge(5, 4);

        G.addEdge(3, 4);

        G.addEdge(4, 6);

        G.addEdge(7, 8);

        G.addEdge(9, 11);
        G.addEdge(9, 10);
        G.addEdge(9, 12);

        G.addEdge(11, 12);
        //准备深度优先搜索对象
        BreadthFirstSearch search = new BreadthFirstSearch(G, 0);

        //测试与某个顶点相通的顶点数量
        int count = search.count();
        System.out.println("与起点0相通的顶点的数量为:" + count);

        //测试某个顶点与起点是否相同
        boolean marked1 = search.marked(5);
        System.out.println("顶点5和顶点0是否相通:" + marked1);

        boolean marked2 = search.marked(7);
        System.out.println("顶点7和顶点0是否相通:" + marked2);

    }
}
1.6 案例交通
某省调查城镇交通状况,得到现有城镇道路统计表,表中列出了每条道路直接连通的城镇。省政府“畅通工程”的目标是使全省任何两个城镇间都可以实现交通(但不一定有直接的道路相连,只要互相间接通过道路可达即可)。目前的道路状况,9号城市和10号城市是否相通?9号城市和8号城市是否相通?
在我们的测试数据文件夹中有一个trffic_project.txt文件,它就是诚征道路统计表,下面是对数据的解释:
总共有20个城市,目前已经修改好了7条道路,问9号城市和10号城市是否相通?9号城市和8号城市是否相通?
package com.ycc.data.structure.graph.test;


import com.ycc.data.structure.graph.DepthFirstSearch;
import com.ycc.data.structure.graph.Graph;

/**
 * @author hezhaoming
 * @date 2020/10/17
 */
public class TrafficProjectTest {

    public static void main(String[] args) throws Exception {


        //构建一个Graph对象
        Graph graph = new Graph(20);
        //0 1
        //6 9
        //3 8
        //5 11
        //2 12
        //6 10
        //4 8
        graph.addEdge(0, 1);
        graph.addEdge(6, 9);
        graph.addEdge(3, 8);
        graph.addEdge(5, 11);
        graph.addEdge(2, 12);
        graph.addEdge(6, 10);
        graph.addEdge(4, 8);
        //构建一个深度优先搜索对象,起点设置为顶点9
        DepthFirstSearch search = new DepthFirstSearch(graph, 9);
        //调用marked方法,判断8顶点和10顶点是否与起点9相通
        System.out.println("顶点8和顶点9是否相通:" + search.marked(8));
        System.out.println("顶点10和顶点9是否相通:" + search.marked(10));

    }
}
1.7 路径查找
1.7.1 路径查找原理
我们实现路径查找,最基本的操作还是得遍历并搜索图,所以,我们的实现暂且基于深度优先搜索来完成。其搜索的过程是比较简单的。我们添加了edgeTo[]整型数组,这个整型数组会记录从每个顶点回到起点s的路径。如果我们把顶点设定为0,那么它的搜索可以表示为下图:

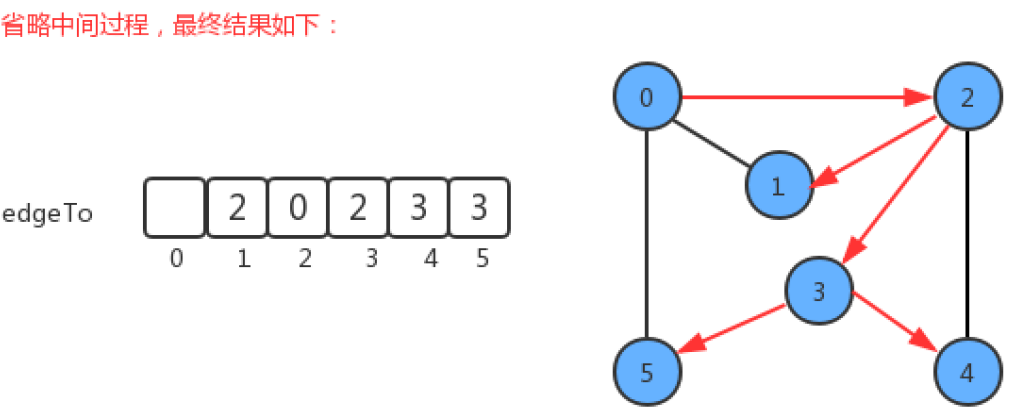
1.7.2 代码实现
package com.ycc.data.structure.graph;

import com.ycc.data.structure.line.MyArrayQueue;
import com.ycc.data.structure.line.MyArrayStack;

public class DepthFirstPaths {
    //索引代表顶点,值表示当前顶点是否已经被搜索
    private boolean[] marked;
    //起点
    private int s;
    //索引代表顶点,值代表从起点s到当前顶点路径上的最后一个顶点
    private int[] edgeTo;

    //构造深度优先搜索对象,使用深度优先搜索找出G图中起点为s的所有路径
    public DepthFirstPaths(Graph G, int s) {
        //初始化marked数组
        this.marked = new boolean[G.V()];
        //初始化起点
        this.s = s;
        //初始化edgeTo数组
        this.edgeTo = new int[G.V()];

        dfs(G, s);
    }

    //使用深度优先搜索找出G图中v顶点的所有相邻顶点
    private void dfs(Graph G, int v) {
        //把v表示为已搜索
        marked[v] = true;
        //遍历顶点v的邻接表,拿到每一个相邻的顶点,继续递归搜索
        MyArrayQueue<Integer> queue = G.adj(v);
        for (int i = 0; i < queue.length(); i++) {
            //如果顶点w没有被搜索,则继续递归搜索
            Integer w = queue.get(i);
            if (!marked[w]) {
                edgeTo[w] = v;//到达顶点w的路径上的最后一个顶点是v
                dfs(G, w);
            }
        }
    }

    //判断w顶点与s顶点是否存在路径
    public boolean hasPathTo(int v) {
        return marked[v];
    }

    //找出从起点s到顶点v的路径(就是该路径经过的顶点)
    public MyArrayStack<Integer> pathTo(int v) {
        if (!hasPathTo(v)) {
            return null;
        }
        //创建栈对象,保存路径中的所有顶点
        MyArrayStack<Integer> path = new MyArrayStack<>();
        //通过循环,从顶点v开始,一直往前找,到找到起点为止
        for (int x = v; x != s; x = edgeTo[x]) {
            path.push(x);
        }
        //把起点s放到栈中
        path.push(s);
        return path;
    }


}
1.8.3 测试代码
package com.ycc.data.structure.graph.test;


import com.ycc.data.structure.graph.DepthFirstPaths;
import com.ycc.data.structure.graph.Graph;
import com.ycc.data.structure.line.MyArrayStack;

public class DepthFirstPathsTest {

    public static void main(String[] args) throws Exception {

        //根据第一行数据构建一副图Graph
        Graph graph = new Graph(6);
        //0 2
        //0 1
        //2 1
        //2 3
        //2 4
        //3 5
        //3 4
        //0 5
        graph.addEdge(0, 2);
        graph.addEdge(0, 1);
        graph.addEdge(2, 1);
        graph.addEdge(2, 3);
        graph.addEdge(2, 4);
        graph.addEdge(3, 5);
        graph.addEdge(3, 4);
        graph.addEdge(0, 5);

        //构建路径查找对象,并设置起点为0
        DepthFirstPaths paths = new DepthFirstPaths(graph, 0);

        //调用 pathTo(4),找到从起点0到终点4的路径,返回Stack
        MyArrayStack<Integer> stack = paths.pathTo(4);
        StringBuilder sb = new StringBuilder();
        //遍历栈对象
        for (int i = 0; i < stack.length(); i++) {
            sb.append(stack.get(i) + "-");
        }
        sb.deleteCharAt(sb.length() - 1);
        System.out.println(sb);
    }
}
1.8 加权无向图
加权无向图是一种为每条边关联一个权重值或是成本的图模型。这种图能够自然地表示许多应用。在一副航空图中,边表示航线,权值则可以表示距离或是费用。在一副电路图中,边表示导线,权值则可能表示导线的长度即成本,或是信号通过这条先所需的时间。此时我们很容易就能想到,最小成本的问题,例如,从西安飞纽约,怎样飞才能使时间成本最低或者是金钱成本最低?
在下图中,从顶点0到顶点4有三条路径,分别为0-2-3-4,0-2-4,0-5-3-4,那我们如果要通过那条路径到达4顶点最好呢?此时就要考虑,那条路径的成本最低。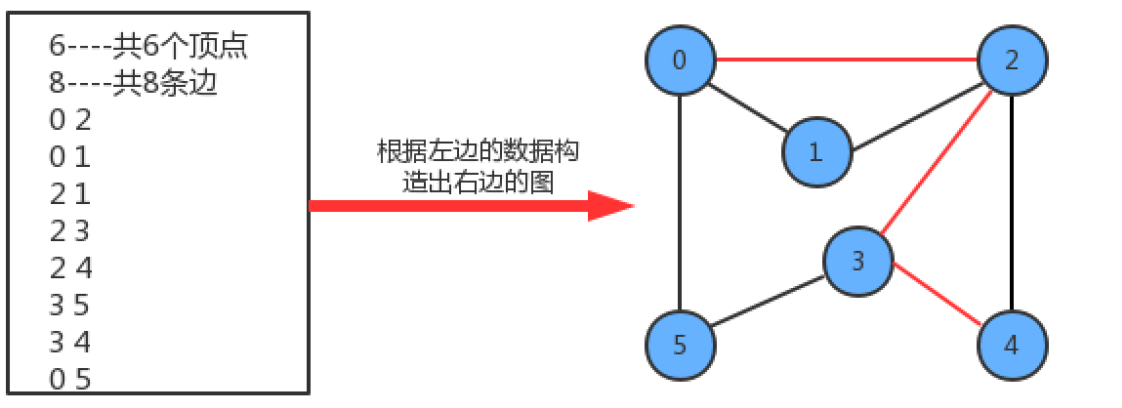
1.8.1 加权无向图边
package com.ycc.data.structure.graph;

/**
 * 带权重的边
 *
 * @author hezhaoming
 * @date 2020/10/17
 */
public class Edge implements Comparable<Edge> {
    private final int v;//顶点一
    private final int w;//顶点二
    private final double weight;//当前边的权重

    //通过顶点v和w,以及权重weight值构造一个边对象
    public Edge(int v, int w, double weight) {
        this.v = v;
        this.w = w;
        this.weight = weight;
    }

    //获取边的权重值
    public double weight() {
        return weight;
    }

    //获取边上的一个点
    public int either() {
        return v;
    }

    //获取边上除了顶点vertex外的另外一个顶点
    public int other(int vertex) {
        if (vertex == v) {
            return w;
        } else {
            return v;
        }
    }

    @Override
    public int compareTo(Edge that) {
        //使用一个遍历记录比较的结果
        int cmp;

        if (this.weight() > that.weight()) {
            //如果当前边的权重值大,则让cmp=1;
            cmp = 1;
        } else if (this.weight() < that.weight()) {
            //如果当前边的权重值小,则让cmp=-1;
            cmp = -1;
        } else {
            //如果当前边的权重值和that边的权重值一样大,则让cmp=0
            cmp = 0;
        }
        return cmp;
    }
}
1.8.2 加权无向图
package com.ycc.data.structure.graph;


import com.ycc.data.structure.line.MyArrayQueue;
/**
 * 加权无向图
 *
 * @author hezhaoming
 * @date 2020/10/17
 */
public class EdgeWeightedGraph {
    //顶点总数
    private final int V;
    //边的总数
    private int E;
    //邻接表
    private MyArrayQueue<Edge>[] adj;

    //创建一个含有V个顶点的空加权无向图
    public EdgeWeightedGraph(int V) {
        //初始化顶点数量
        this.V = V;
        //初始化边的数量
        this.E = 0;
        //初始化邻接表
        this.adj = new MyArrayQueue[V];
        for (int i = 0; i < adj.length; i++) {
            adj[i] = new MyArrayQueue<Edge>();
        }

    }

    //获取图中顶点的数量
    public int V() {
        return V;
    }

    //获取图中边的数量
    public int E() {
        return E;
    }


    //向加权无向图中添加一条边e
    public void addEdge(Edge e) {
        //需要让边e同时出现在e这个边的两个顶点的邻接表中
        int v = e.either();
        int w = e.other(v);

        adj[v].enQueue(e);
        adj[w].enQueue(e);

        //边的数量+1
        E++;
    }

    //获取和顶点v关联的所有边
    public MyArrayQueue<Edge> adj(int v) {
        return adj[v];
    }

    //获取加权无向图的所有边
    public MyArrayQueue<Edge> edges() {

        //创建一个队列对象,存储所有的边
        MyArrayQueue<Edge> allEdges = new MyArrayQueue<>();

        //遍历图中的每一个顶点,找到该顶点的邻接表,邻接表中存储了该顶点关联的每一条边

        //因为这是无向图,所以同一条边同时出现在了它关联的两个顶点的邻接表中,需要让一条边只记录一次;
        for (int v = 0; v < V; v++) {
            //遍历v顶点的邻接表,找到每一条和v关联的边
            MyArrayQueue<Edge> arrayQueue = adj(v);
            for (int i = 0; i < arrayQueue.length(); i++) {
                Edge edge = arrayQueue.get(i);
                if (edge.other(v) < v) {
                    allEdges.enQueue(edge);
                }
            }
        }
        return allEdges;
    }
}
二 有向图
有向图是一副具有方向性的图,是由一组顶点和一组有方向的边组成的,每条方向的边都连着一对有序的顶点。
2.1 有向图定义
- 出度
- 由某个顶点指出的边的个数称为该顶点的出度。
- 入度
- 指向某个顶点的边的个数称为该顶点的入度。
- 有向路径
- 由一系列顶点组成,对于其中的每个顶点都存在一条有向边,从它指向序列中的下一个顶点。
- 有向环
2.2 实现原理
2.3 有向图代码
package com.ycc.data.structure.graph;


import com.ycc.data.structure.line.MyArrayQueue;

/**
 * 有向图
 *
 * @author hezhaoming
 * @date 2020/10/16
 */
public class Digraph {
    //顶点数目
    private final int V;
    //边的数目
    private int E;
    //邻接表
    private MyArrayQueue<Integer>[] adj;

    public Digraph(int V) {
        //初始化顶点数量
        this.V = V;
        //初始化边的数量
        this.E = 0;
        //初始化邻接表
        this.adj = new MyArrayQueue[V];
        for (int i = 0; i < adj.length; i++) {
            adj[i] = new MyArrayQueue<Integer>();
        }

    }


    //获取顶点数目
    public int V() {
        return V;
    }

    //获取边的数目
    public int E() {
        return E;
    }

    //向有向图中添加一条边 v->w
    public void addEdge(int v, int w) {
        //只需要让顶点w出现在顶点v的邻接表中,因为边是有方向的,最终,顶点v的邻接表中存储的相邻顶点的含义是:  v->其他顶点
        adj[v].enQueue(w);
        E++;
    }

    //获取由v指出的边所连接的所有顶点
    public MyArrayQueue<Integer> adj(int v) {
        return adj[v];
    }

    //该图的反向图
    private Digraph reverse() {
        //创建有向图对象
        Digraph r = new Digraph(V);

        for (int v = 0; v < V; v++) {
            //获取由该顶点v指出的所有边
            for (Integer w : adj[v]) {//原图中表示的是由顶点v->w的边
                r.addEdge(w, v);//w->v
            }
        }
        return r;
    }
}
2.4 拓扑排序
2.4.1 定义
有向图将所有的顶点排序,使得所有的有向边均从排在前面的元素指向排在后面的元素,此时就可以明确的表示出每个顶点的优先级。
举例理解:
在现实生活中,我们经常会同一时间接到很多任务去完成,但是这些任务的完成是有先后次序的。以我们学习java学科为例,我们需要学习很多知识,但是这些知识在学习的过程中是需要按照先后次序来完成的。从java基础,到jsp/servlet,到ssm,到springboot等是个循序渐进且有依赖的过程。在学习jsp前要首先掌握java基础和html基础,学习ssm框架前要掌握jsp/servlet之类才行。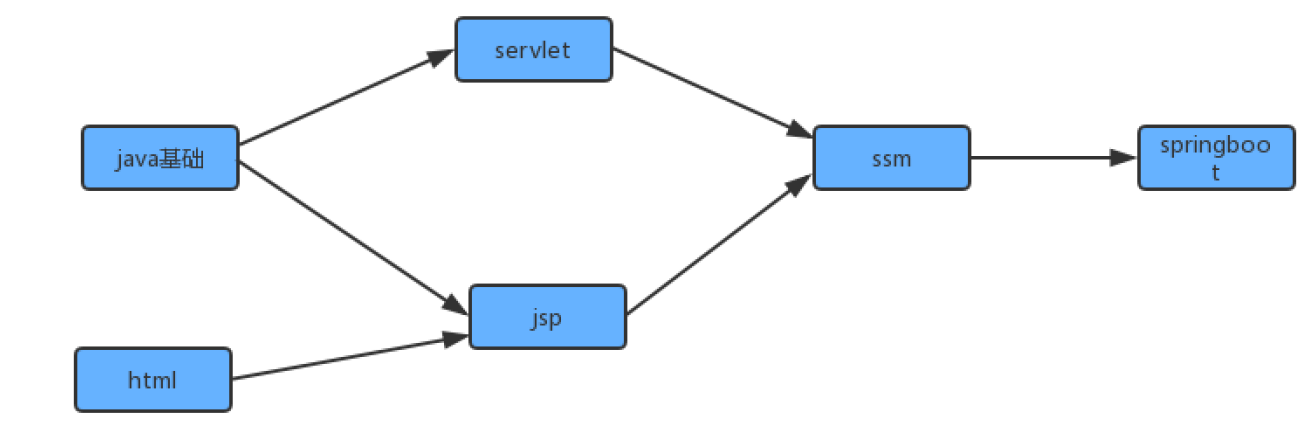
为了简化问题,我们使用整数为顶点编号的标准模型来表示这个案例: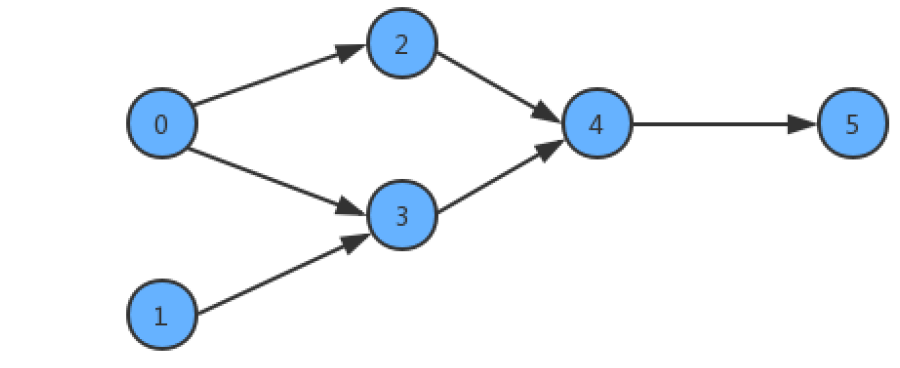
此时如果某个同学要学习这些课程,就需要指定出一个学习的方案,我们只需要对图中的顶点进行排序,让它转换为一个线性序列,就可以解决问题,这时就需要用到一种叫拓扑排序的算法。
变成如下图所示:
2.4.2 环的问题
如果学习x课程前必须先学习y课程,学习y课程前必须先学习z课程,学习z课程前必须先学习x课程,那么一定是有问题了,我们就没有办法学习了,因为这三个条件没有办法同时满足。其实这三门课程x、y、z的条件组成了一个环。
因此,如果我们要使用拓扑排序解决优先级问题,首先得保证图中没有环的存在。
2.4.3 检测环原理
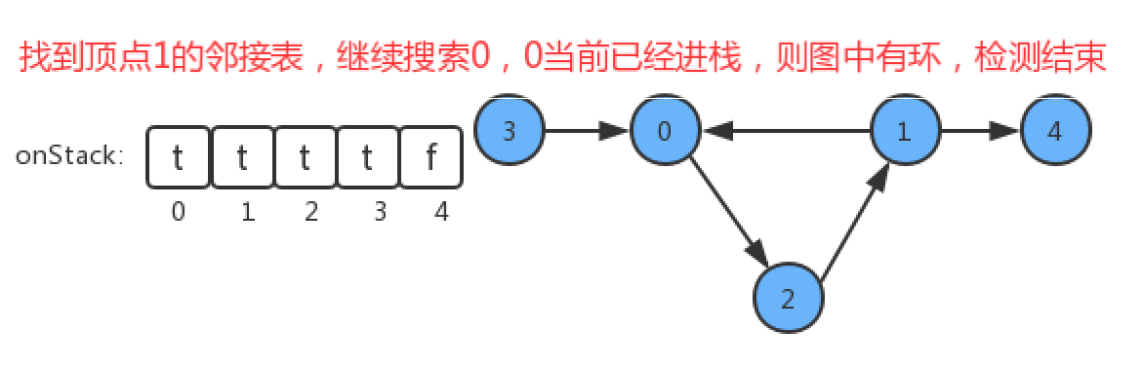
在API中添加了onStack[] 布尔数组,索引为图的顶点,当我们深度搜索时:
1. 在如果当前顶点正在搜索,则把对应的onStack数组中的值改为true,标识进栈;
2. 如果当前顶点搜索完毕,则把对应的onStack数组中的值改为false,标识出栈;
3. 如果即将要搜索某个顶点,但该顶点已经在栈中,则图中有环;


2.4.4 代码实现
package com.ycc.data.structure.graph;


import com.ycc.data.structure.line.MyArrayQueue;

/**
 * 检测有向环
 *
 * @author hezhaoming
 * @date 2020/10/16
 */

public class DirectedCycle {
    //索引代表顶点,值表示当前顶点是否已经被搜索
    private boolean[] marked;
    //记录图中是否有环
    private boolean hasCycle;
    //索引代表顶点,使用栈的思想,记录当前顶点有没有已经处于正在搜索的有向路径上
    private boolean[] onStack;

    //创建一个检测环对象,检测图G中是否有环
    public DirectedCycle(Digraph G) {
        //初始化marked数组
        this.marked = new boolean[G.V()];
        //初始化hasCycle
        this.hasCycle = false;
        //初始化onStack数组
        this.onStack = new boolean[G.V()];

        //找到图中每一个顶点,让每一个顶点作为入口,调用一次dfs进行搜索
        for (int v = 0; v < G.V(); v++) {
            //判断如果当前顶点还没有搜索过,则调用dfs进行搜索
            if (!marked[v]) {
                dfs(G, v);
            }

        }

    }

    //基于深度优先搜索,检测图G中是否有环
    private void dfs(Digraph G, int v) {
        //把顶点v表示为已搜索
        marked[v] = true;
        //把当前顶点进栈
        onStack[v] = true;

        MyArrayQueue<Integer> queue = G.adj(v);

        //进行深度搜索
        for (int i = 0; i < queue.length(); i++) {
            Integer w = queue.get(i);
            //判断如果当前顶点w没有被搜索过,则继续递归调用dfs方法完成深度优先搜索
            if (!marked[w]) {
                dfs(G, w);
            }

            //判断当前顶点w是否已经在栈中,如果已经在栈中,证明当前顶点之前处于正在搜索的状态,那么现在又要搜索一次,证明检测到环了
            if (onStack[w]) {
                hasCycle = true;
                return;
            }
        }
        //把当前顶点出栈
        onStack[v] = false;
    }

    //判断当前有向图G中是否有环
    public boolean hasCycle() {
        return hasCycle;
    }

}
2.4.5 顶点排序
如果要把图中的顶点生成线性序列其实是一件非常简单的事,之前我们学习并使用了多次深度优先搜索,我们会发
现其实深度优先搜索有一个特点,那就是在一个连通子图上,每个顶点只会被搜索一次,如果我们能在深度优先搜
索的基础上,添加一行代码,只需要将搜索的顶点放入到线性序列的数据结构中,我们就能完成这件事。
2.4.6 顶点排序原理
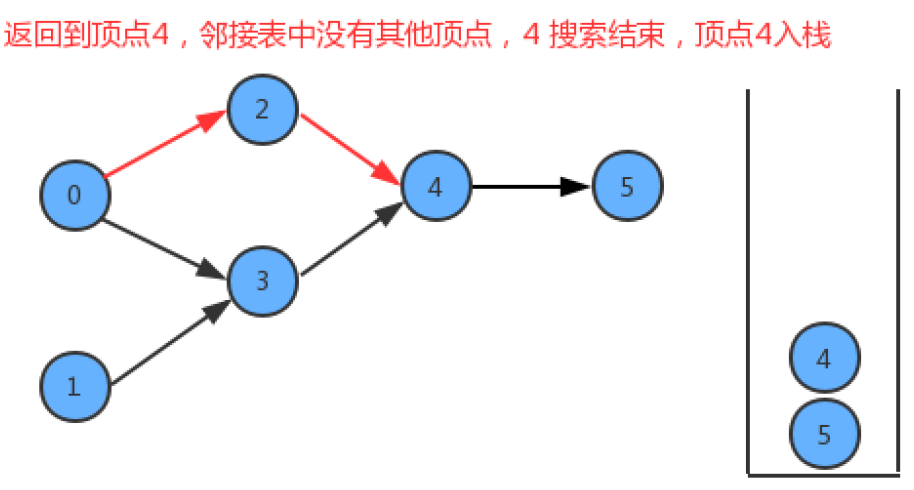
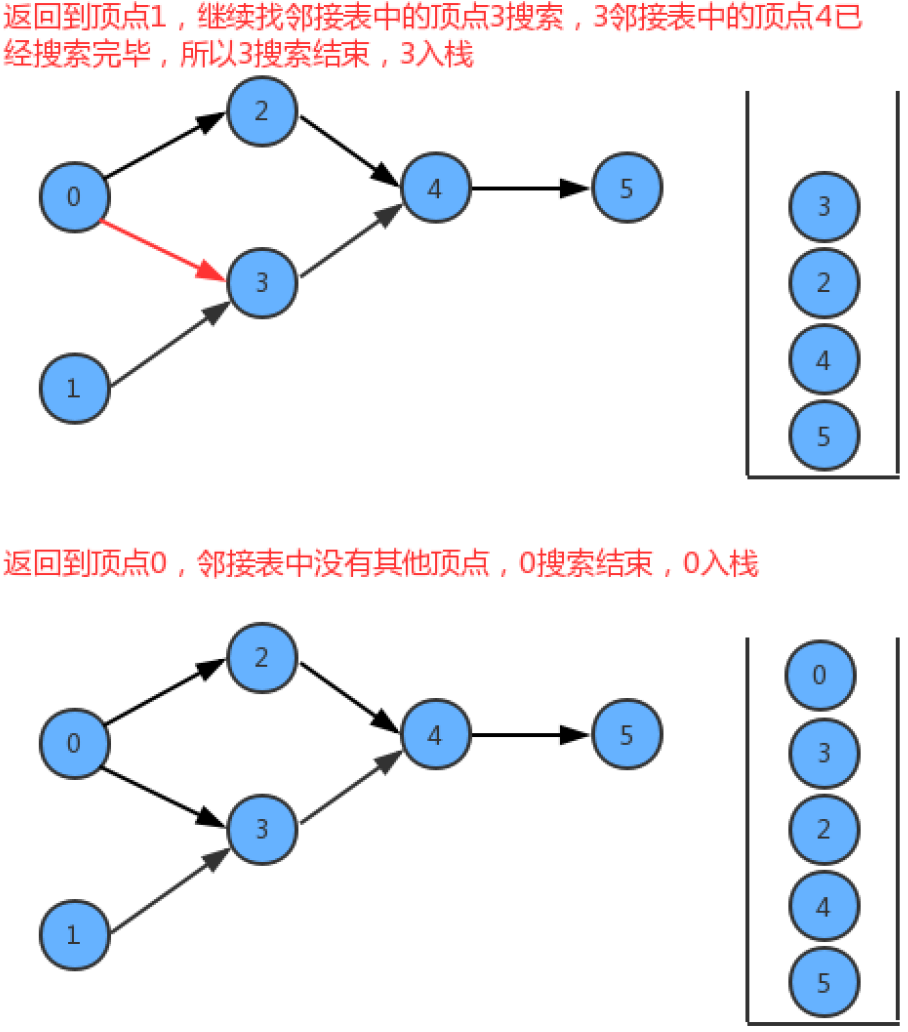
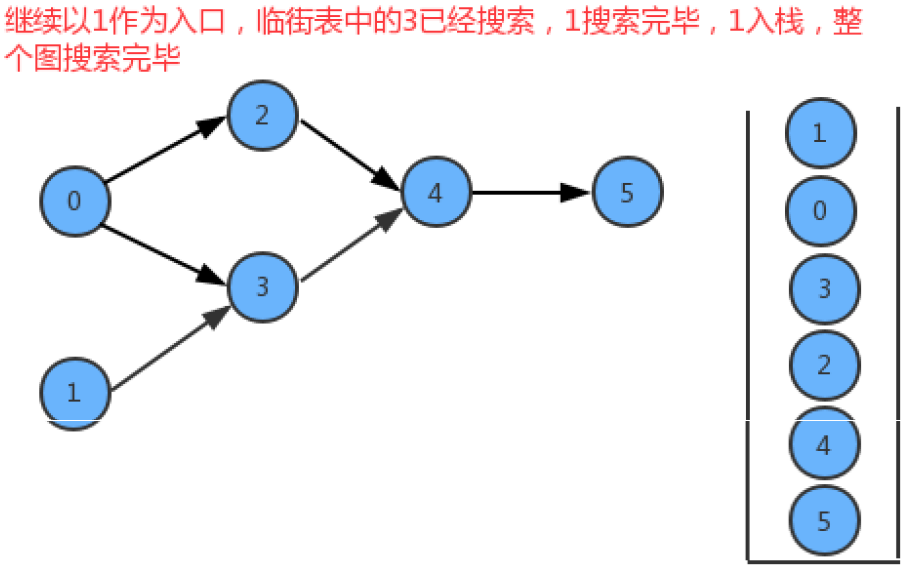
顶点排序实现在API的设计中,我们添加了一个栈reversePost用来存储顶点,当我们深度搜索图时,每搜索完毕一个顶点,把该顶点放入到reversePost中,这样就可以实现顶点排序。
图解: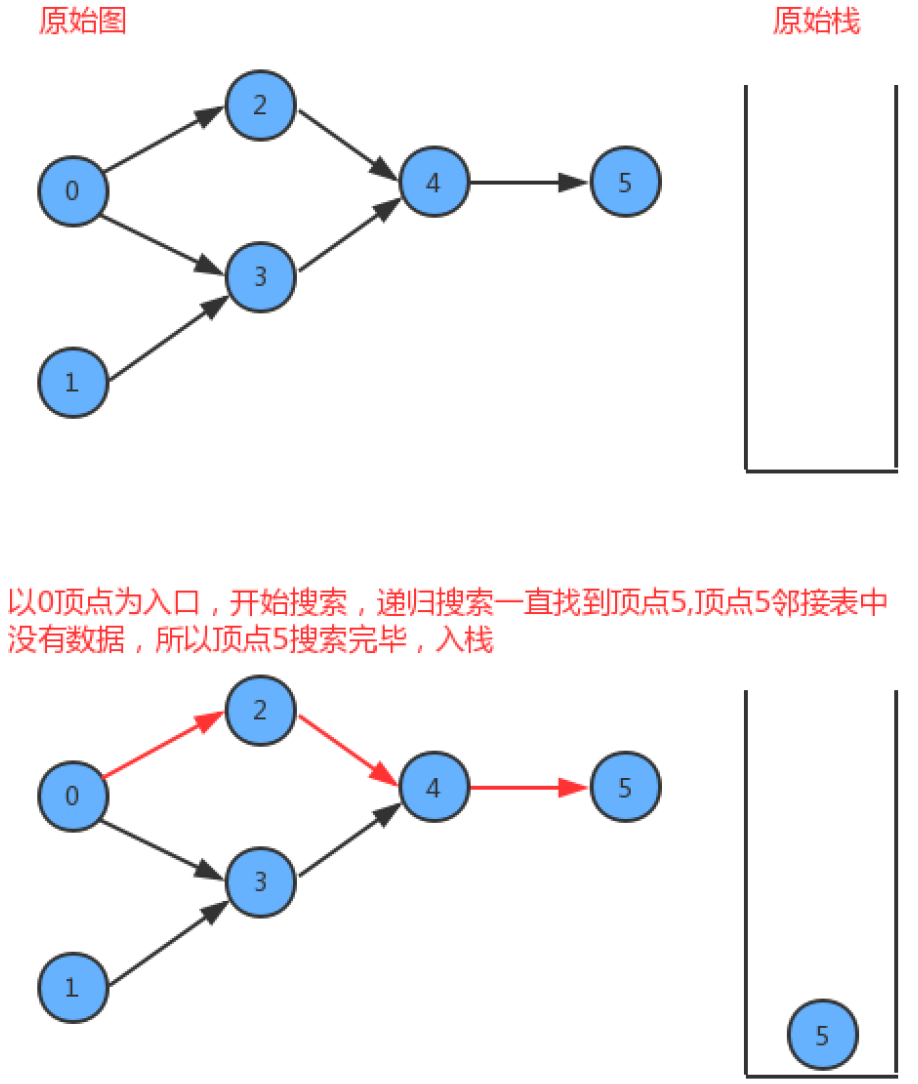

2.4.7 代码实现
package com.ycc.data.structure.graph;

import com.ycc.data.structure.line.MyArrayQueue;
import com.ycc.data.structure.line.MyArrayStack;

/**
 * 顶点排序
 *
 * @author hezhaoming
 * @date 2020/10/17
 */

public class DepthFirstOrder {
    //索引代表顶点,值表示当前顶点是否已经被搜索
    private boolean[] marked;
    //使用栈,存储顶点序列
    private MyArrayStack<Integer> reversePost;

    //创建一个检测环对象,检测图G中是否有环
    public DepthFirstOrder(Digraph G) {
        //初始化marked数组
        this.marked = new boolean[G.V()];
        //初始化reversePost栈
        this.reversePost = new MyArrayStack<Integer>();

        //遍历图中的每一个顶点,让每个顶点作为入口,完成一次深度优先搜索
        for (int v = 0; v < G.V(); v++) {
            if (!marked[v]) {
                dfs(G, v);
            }
        }
    }

    //基于深度优先搜索,把顶点排序
    private void dfs(Digraph G, int v) {
        //标记当前v已经被搜索
        marked[v] = true;
        //通过循环深度搜索顶点v
        MyArrayQueue<Integer> arrayQueue = G.adj(v);
        for (int i = 0; i < arrayQueue.length(); i++) {
            Integer w = arrayQueue.get(i);
            //如果当前顶点w没有搜索,则递归调用dfs进行搜索
            if (!marked[w]) {
                dfs(G, w);
            }
        }
        //让顶点v进栈
        reversePost.push(v);
    }

    //获取顶点线性序列
    public MyArrayStack<Integer> reversePost() {
        return reversePost;
    }
}
2.4.8 拓扑排序
基于一幅图,先检测有没有环,如果没有环,则调用顶点排序即可
package com.ycc.data.structure.graph;


import com.ycc.data.structure.line.MyArrayStack;

/**
 * @author hezhaoming
 * @date 2020/10/17
 */

public class Topology {
    //顶点的拓扑排序
    private MyArrayStack<Integer> order;

    //构造拓扑排序对象
    public Topology(Digraph G) {
        //创建一个检测有向环的对象
        DirectedCycle cycle = new DirectedCycle(G);
        //判断G图中有没有环,如果没有环,则进行顶点排序:创建一个顶点排序对象
        if (!cycle.hasCycle()) {
            DepthFirstOrder depthFirstOrder = new DepthFirstOrder(G);
            order = depthFirstOrder.reversePost();
        }
    }

    //判断图G是否有环
    private boolean isCycle() {
        return order == null;
    }

    //获取拓扑排序的所有顶点
    public MyArrayStack<Integer> order() {
        return order;
    }
}
2.5 加权有向图
2.5.1 加权有向边
package com.ycc.data.structure.graph;

/**
 * 有向边
 *
 * @author hezhaoming
 * @date 2020/10/19
 */
public class DirectedEdge {
    private final int v;//起点
    private final int w;//终点
    private final double weight;//当前边的权重

    //通过顶点v和w,以及权重weight值构造一个边对象
    public DirectedEdge(int v, int w, double weight) {
        this.v = v;
        this.w = w;
        this.weight = weight;
    }

    //获取边的权重值
    public double weight() {
        return weight;
    }

    //获取有向边的起点
    public int from() {
        return v;
    }

    //获取有向边的终点
    public int to() {
        return w;
    }
}
2.5.2 加权有向图
package com.ycc.data.structure.graph;


import com.ycc.data.structure.line.MyArrayQueue;

/**
 * 加权有向图
 *
 * @author hezhaoming
 * @date 2020/10/19
 */
public class EdgeWeightedDigraph {
    //顶点总数
    private final int V;
    //边的总数
    private int E;
    //邻接表
    private MyArrayQueue<DirectedEdge>[] adj;

    //创建一个含有V个顶点的空加权有向图
    public EdgeWeightedDigraph(int V) {
        //初始化顶点数量
        this.V = V;
        //初始化边的数量
        this.E = 0;
        //初始化邻接表
        this.adj = new MyArrayQueue[V];
        for (int i = 0; i < adj.length; i++) {
            adj[i] = new MyArrayQueue<DirectedEdge>();
        }
    }

    //获取图中顶点的数量
    public int V() {
        return V;
    }

    //获取图中边的数量
    public int E() {
        return E;
    }


    //向加权有向图中添加一条边e
    public void addEdge(DirectedEdge e) {
        //边e是有方向的,所以只需要让e出现在起点的邻接表中即可
        int v = e.from();
        adj[v].enQueue(e);
        E++;
    }

    //获取由顶点v指出的所有的边
    public MyArrayQueue<DirectedEdge> adj(int v) {
        return adj[v];
    }

    //获取加权有向图的所有边
    public MyArrayQueue<DirectedEdge> edges() {
        //遍历图中的每一个顶点,得到该顶点的邻接表,遍历得到每一条边,添加到队列中返回即可
        MyArrayQueue<DirectedEdge> allEdges = new MyArrayQueue<>();
        for (int v = 0; v < V; v++) {
            for (DirectedEdge edge : adj[v]) {
                allEdges.enQueue(edge);
            }
        }
        return allEdges;
    }
}
三 最小生成树
图的生成树是它的一棵含有其所有顶点的无环连通子图,一副加权无向图的最小生成树它的一棵权值(树中所有边的权重之和)最小的生成树。
所以具备以下性质:
- 用一条边接树中的任意两个顶点都会产生一个新的环
- 从树中删除任意一条边,将会得到两棵独立的树
3.1 贪心算法思想
贪心算法是计算图的最小生成树的基础算法,它的基本原理就是切分定理,使用切分定理找到最小生成树的一条边,不断的重复直到找到最小生成树的所有边。如果图有V个顶点,那么需要找到V-1条边,就可以表示该图的最小生成树。
在一副加权图中,给定任意的切分,它的横切边中的权重最小者必然属于图中的最小生成树
3.2 Prim算法
它的每一步都会为一棵生成中的树添加一条边。一开始这棵树只有一个顶点,然后会向它添加V-1条边,每次总是将下一条连接树中的顶点与不在树中的顶点且权重最小的边加入到树中。
3.2.1 实现原理
Prim算法将图中的顶点切分成两个集合,最小生成树顶点和非最小生成树顶点,通过不断的重复做某些操作,可以逐渐将非最小生成树中的顶点加入到最小生成树中,直到所有的顶点都加入到最小生成树中。
- 使用最小索引优先队列存放树中顶点与非树中顶点的有效横切边
- 我们可以让最小索引优先队列的索引值表示图的顶点,让最小索引优先队列中的值表示从其他某个顶点到当前顶点的边权重
- 初始化状态,先默认0是最小生成树中的唯一顶点,其他的顶点都不在最小生成树中,此时横切边就是顶点0的邻接表中0-2,0-4,0-6,0-7这四条边,我们只需要将索引优先队列的2、4、6、7索引处分别存储这些边的权重值就可以表示了
- 只需要从这四条横切边中找出权重最小的边,然后把对应的顶点加进来即可。所以找到0-7这条横切边的权重最小,因此把0-7这条边添加进来,此时0和7属于最小生成树的顶点,其他的不属于.
- 0-7这条边已经不是横切边了,需要让它失效:只需要调用最小索引优先队列的delMin()方法即可完成;
- 2和4顶点各有两条连接指向最小生成树,需要只保留一条:4-7的权重小于0-4的权重,所以保留4-7,调用索引优先队列的change(4,0.37)即可,0-2的权重小于2-7的权重,所以保留0-2,不需要做额外操作。
- 我们不断重复上面的动作,就可以把所有的顶点添加到最小生成树中。
3.2.2 代码实现
```java package com.ycc.data.structure.graph;
import com.ycc.data.structure.heap.IndexMinPriorityQueue; import com.ycc.data.structure.line.MyArrayQueue;
/**
- Prim 最小生成树 *
- @author hezhaoming
@date 2020/10/19 */ public class PrimMST { //索引代表顶点,值表示当前顶点和最小生成树之间的最短边 private Edge[] edgeTo; //索引代表顶点,值表示当前顶点和最小生成树之间的最短边的权重 private double[] distTo; //索引代表顶点,如果当前顶点已经在树中,则值为true,否则为false private boolean[] marked; //存放树中顶点与非树中顶点之间的有效横切边 private IndexMinPriorityQueue
pq; //根据一副加权无向图,创建最小生成树计算对象 public PrimMST(EdgeWeightedGraph G) {
 //初始化edgeTo
 this.edgeTo = new Edge[G.V()];
 //初始化distTo
 this.distTo = new double[G.V()];
 for (int i = 0; i < distTo.length; i++) {
     distTo[i] = Double.POSITIVE_INFINITY;
 }
 //初始化marked
 this.marked = new boolean[G.V()];
 //初始化pq
 pq = new IndexMinPriorityQueue<Double>(G.V());

 //默认让顶点0进入到树中,但是树中只有一个顶点0,因此,0顶点默认没有和其他的顶点相连,所以让distTo对应位置处的值存储0.0
 distTo[0] = 0.0;
 pq.insert(0, 0.0);

 //遍历索引最小优先队列,拿到最小和N切边对应的顶点,把该顶点加入到最小生成树中
 while (!pq.isEmpty()) {
     visit(G, pq.delMin());
 }
}
//将顶点v添加到最小生成树中,并且更新数据
private void visit(EdgeWeightedGraph G, int v) {
    //把顶点v添加到最小生成树中
    marked[v] = true;
    //更新数据
    MyArrayQueue<Edge> arrayQueue = G.adj(v);
    for (int i = 0; i < arrayQueue.length(); i++) {
        Edge e = arrayQueue.get(i);
        //获取e边的另外一个顶点(当前顶点是v)
        int w = e.other(v);
        //判断另外一个顶点是不是已经在树中,如果在树中,则不做任何处理,如果不再树中,更新数据
        if (marked[w]) {
            continue;
        }
        //判断边e的权重是否小于从w顶点到树中已经存在的最小边的权重;
        if (e.weight() < distTo[w]) {
            //更新数据
            edgeTo[w] = e;
            distTo[w] = e.weight();
            if (pq.contains(w)) {
                pq.changeItem(w, e.weight());
            } else {
                pq.insert(w, e.weight());
            }
        }
    }
}

//获取最小生成树的所有边
public MyArrayQueue<Edge> edges() {
    //创建队列对象
    MyArrayQueue<Edge> allEdges = new MyArrayQueue<>();
    //遍历edgeTo数组,拿到每一条边,如果不为null,则添加到队列中
    for (int i = 0; i < edgeTo.length; i++) {
        if (edgeTo[i] != null) {
            allEdges.enQueue(edgeTo[i]);
        }
    }
    return allEdges;
}
}
<a name="Nsn8I"></a>
### 3.2.3 代码测试
```java
package com.ycc.data.structure.graph.test;


import com.ycc.data.structure.graph.Edge;
import com.ycc.data.structure.graph.EdgeWeightedGraph;
import com.ycc.data.structure.graph.PrimMST;
import com.ycc.data.structure.line.MyArrayQueue;

public class PrimMSTTest {

    public static void main(String[] args) throws Exception {

        //8
        //16
        //4 5 0.35
        //4 7 0.37
        //5 7 0.28
        //0 7 0.16
        //1 5 0.32
        //0 4 0.38
        //2 3 0.17
        //1 7 0.19
        //0 2 0.26
        //1 2 0.36
        //1 3 0.29
        //2 7 0.34
        //6 2 0.40
        //3 6 0.52
        //6 0 0.58
        //6 4 0.93
        EdgeWeightedGraph graph = new EdgeWeightedGraph(8);
        graph.addEdge(new Edge(4, 5, 0.35));
        graph.addEdge(new Edge(4, 7, 0.37));
        graph.addEdge(new Edge(5, 7, 0.28));
        graph.addEdge(new Edge(0, 7, 0.16));
        graph.addEdge(new Edge(1, 5, 0.32));
        graph.addEdge(new Edge(0, 4, 0.38));
        graph.addEdge(new Edge(2, 3, 0.17));
        graph.addEdge(new Edge(1, 7, 0.19));
        graph.addEdge(new Edge(0, 2, 0.26));
        graph.addEdge(new Edge(1, 2, 0.36));
        graph.addEdge(new Edge(1, 3, 0.29));
        graph.addEdge(new Edge(2, 7, 0.34));
        graph.addEdge(new Edge(6, 2, 0.40));
        graph.addEdge(new Edge(3, 6, 0.52));
        graph.addEdge(new Edge(6, 0, 0.58));
        graph.addEdge(new Edge(6, 4, 0.93));

        //创建一个PrimMST对象,计算加权无向图中的最小生成树
        PrimMST primMST = new PrimMST(graph);
        //获取最小生成树中的所有边
        MyArrayQueue<Edge> edges = primMST.edges();
        //遍历打印所有的边
        for (int i = 0; i < edges.length(); i++) {
            Edge edge = edges.get(i);
            int v = edge.either();
            int w = edge.other(v);
            System.out.println(v + "-" + w + " :: " + edge.weight());
        }
    }
}
输出结果
1-7 :: 0.19
0-2 :: 0.26
2-3 :: 0.17
4-5 :: 0.35
5-7 :: 0.28
6-2 :: 0.4
0-7 :: 0.16
3.3 kruskal算法
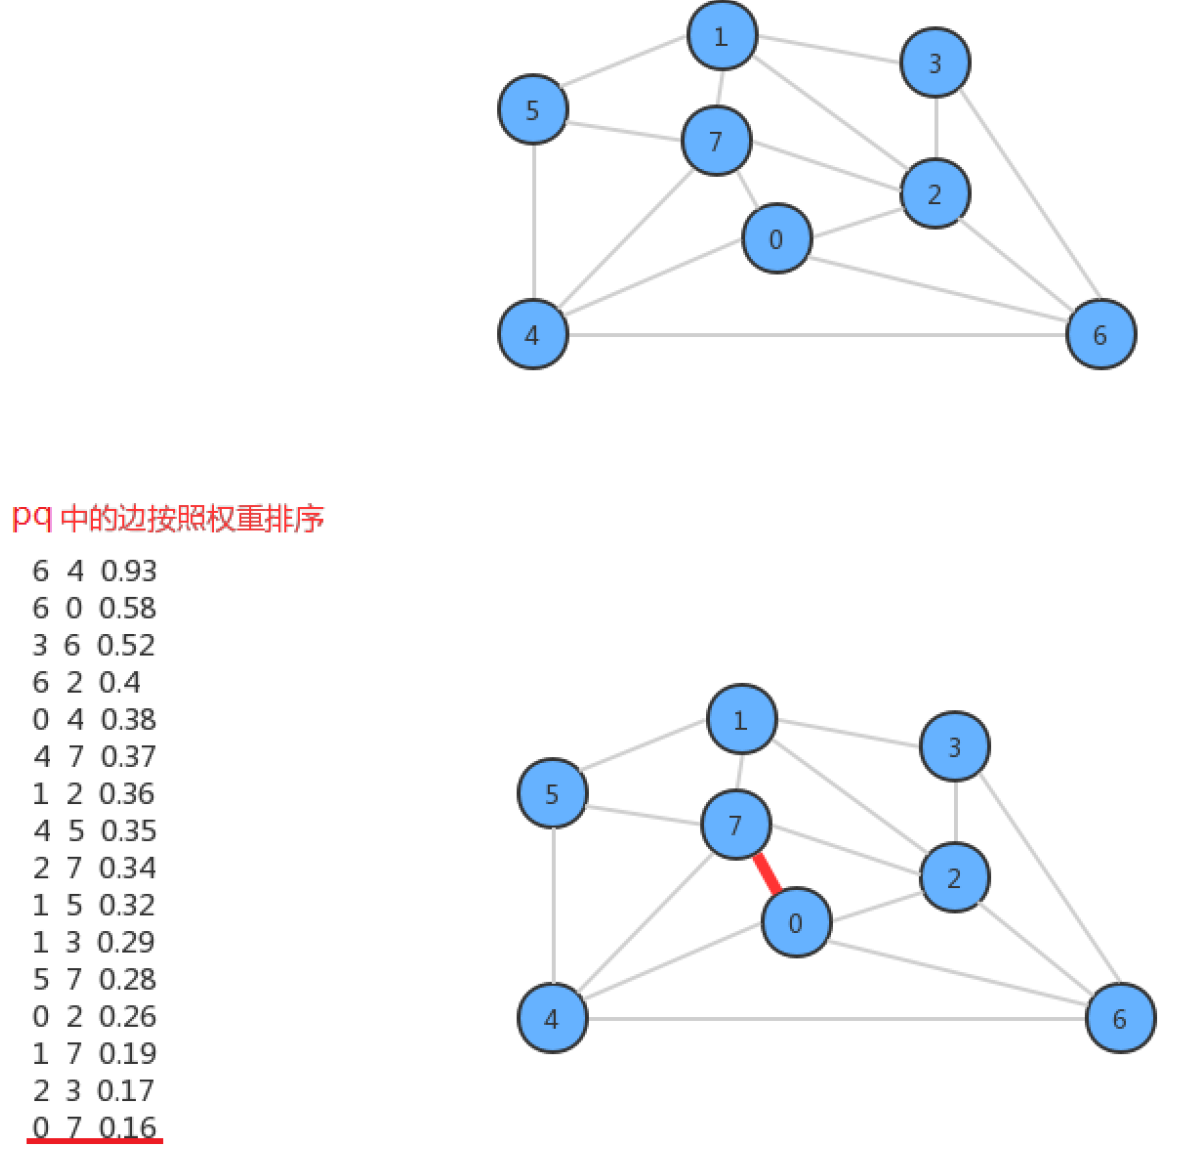
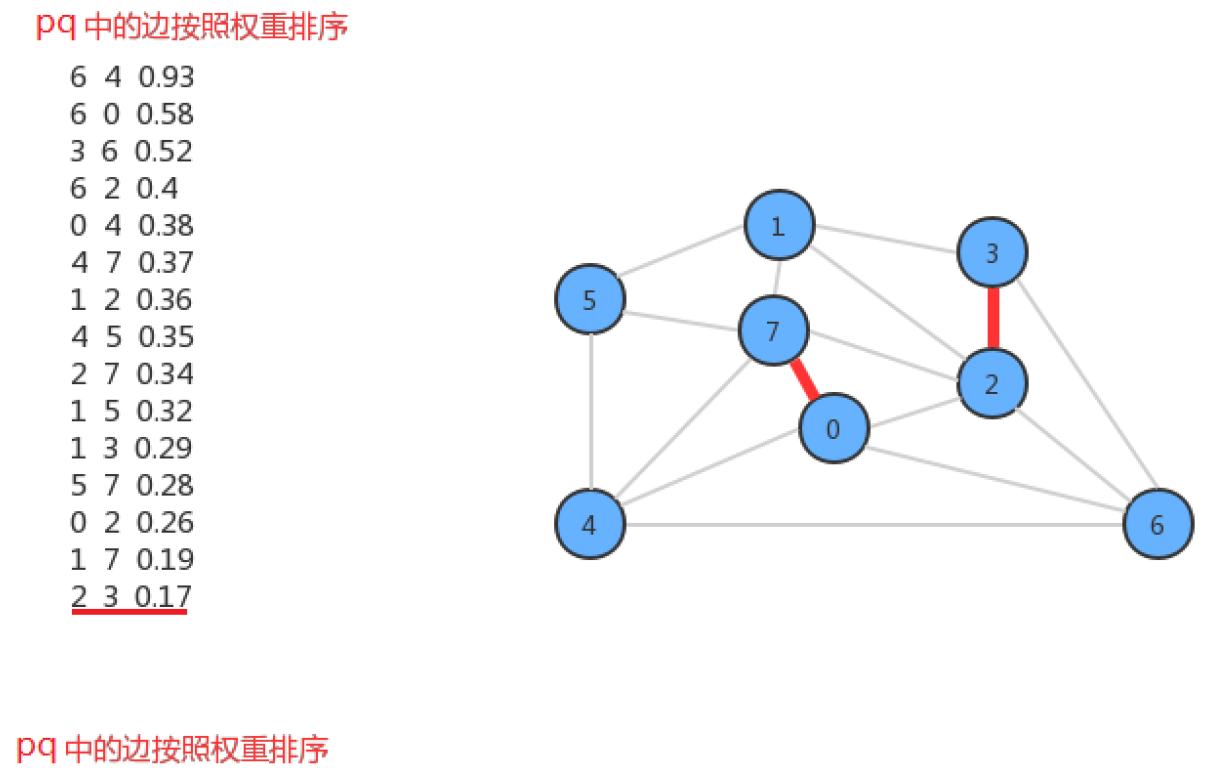
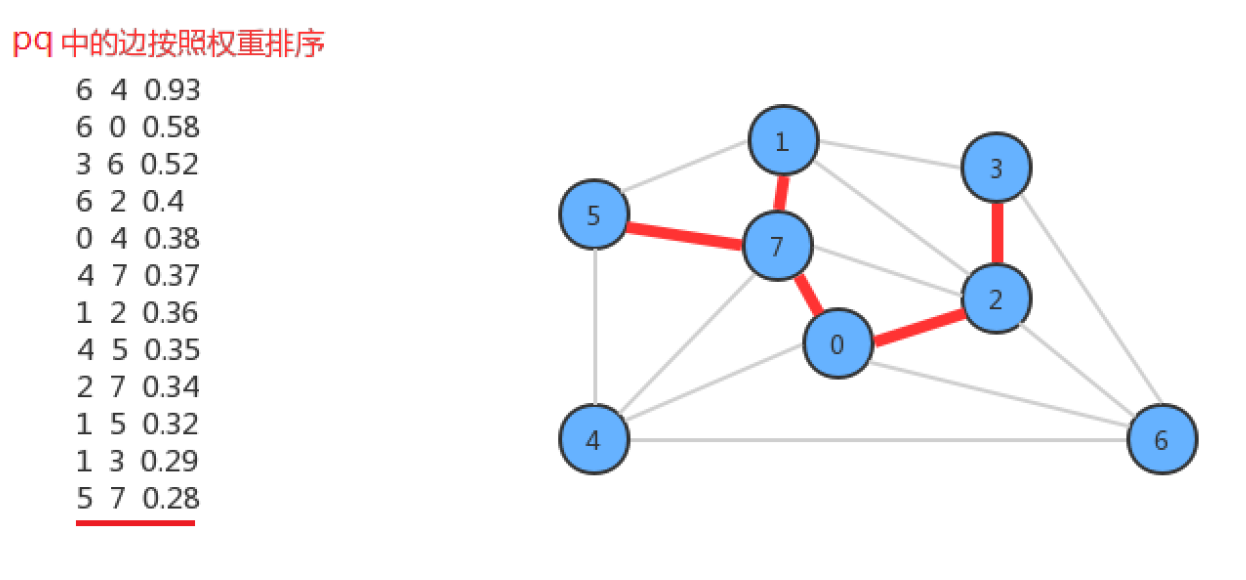
它的主要思想是按照边的权重(从小到大)处理它们,将边加入最小生成树中,加入的边不会与已经加入最小生成树的边构成环,直到树中含有V-1条边为止。
3.3.1 实现原理
- Prim算法是一条边一条边的构造最小生成树,每一步都为一棵树添加一条边。
- kruskal算法构造最小生成树的时候也是一条边一条边地构造,但它的切分规则是不一样的。它每一次寻找的边会连接一片森林中的两棵树。如果一副加权无向图由V个顶点组成,初始化情况下每个顶点都构成一棵独立的树,则V个顶点对应V棵树,组成一片森林,
- kruskal算法每一次处理都会将两棵树合并为一棵树,直到整个森林中只剩一棵树为止。

具体实现步骤
- 使用了一个MinPriorityQueue pq存储图中所有的边,每次使用pq.delMin()取出权重最小的边,并得到该边关联的两个顶点v和w,
- 通过uf.connect(v,w)判断v和w是否已经连通,如果连通,则证明这两个顶点在同一棵树中,那么就不能再把这条边添加到最小生成树中,因为在一棵树的任意两个顶点上添加一条边,都会形成环,而最小生成树不能有环的存在,
- 如果不连通,则通过uf.connect(v,w)把顶点v所在的树和顶点w所在的树合并成一棵树,并把这条边加入到mst队列中,这样如果把所有的边处理完,最终mst中存储的就是最小生树的所有边


3.3.2 代码实现
package com.ycc.data.structure.graph;


import com.ycc.data.structure.heap.MinPriorityQueue;
import com.ycc.data.structure.line.MyArrayQueue;
import com.ycc.data.structure.uf.UFTreeWeighted;

/**
 * 最小生成树
 *
 * @author hezhaoming
 * @date 2020/10/19
 */

public class KruskalMST {
    //保存最小生成树的所有边
    private MyArrayQueue<Edge> mst;
    //索引代表顶点,使用uf.connect(v,w)可以判断顶点v和顶点w是否在同一颗树中,使用uf.union(v,w)可以把顶点v所在的树和顶点w所在的树合并
    private UFTreeWeighted uf;
    //存储图中所有的边,使用最小优先队列,对边按照权重进行排序
    private MinPriorityQueue<Edge> pq;

    //根据一副加权无向图,创建最小生成树计算对象
    public KruskalMST(EdgeWeightedGraph G) {

        //初始化mst
        this.mst = new MyArrayQueue<Edge>();
        //初始化uf
        this.uf = new UFTreeWeighted(G.V());
        //初始化pq
        this.pq = new MinPriorityQueue<>(G.E() + 1);
        MyArrayQueue<Edge> arrayQueue = G.edges();
        //把图中所有的边存储到pq中
        for (int i = 0; i < arrayQueue.length(); i++) {
            Edge edge = arrayQueue.get(i);
            pq.enqueue(edge);
        }

        //遍历pq队列,拿到最小权重的边,进行处理
        while (!pq.isEmpty() && mst.length() < G.V() - 1) {
            //找到权重最小的边
            Edge e = pq.dequeue();
            //找到该边的两个顶点
            int v = e.either();
            int w = e.other(v);

            //判断这两个顶点是否已经在同一颗树中,如果在同一颗树中,则不对该边做处理,如果不在一棵树中,则让这两个顶点属于的两棵树合并成一棵树
            if (uf.connected(v, w)) {
                continue;
            }
            uf.union(v, w);
            //让边e进入到mst队列中
            mst.enQueue(e);
        }

    }

    //获取最小生成树的所有边
    public MyArrayQueue<Edge> edges() {
        return mst;
    }
}
3.3.3 测试代码
package com.ycc.data.structure.graph.test;


import com.ycc.data.structure.graph.Edge;
import com.ycc.data.structure.graph.EdgeWeightedGraph;
import com.ycc.data.structure.graph.KruskalMST;
import com.ycc.data.structure.line.MyArrayQueue;

public class KruskalMSTTest {

    public static void main(String[] args) throws Exception {


        EdgeWeightedGraph graph = new EdgeWeightedGraph(8);
        graph.addEdge(new Edge(4, 5, 0.35));
        graph.addEdge(new Edge(4, 7, 0.37));
        graph.addEdge(new Edge(5, 7, 0.28));
        graph.addEdge(new Edge(0, 7, 0.16));
        graph.addEdge(new Edge(1, 5, 0.32));
        graph.addEdge(new Edge(0, 4, 0.38));
        graph.addEdge(new Edge(2, 3, 0.17));
        graph.addEdge(new Edge(1, 7, 0.19));
        graph.addEdge(new Edge(0, 2, 0.26));
        graph.addEdge(new Edge(1, 2, 0.36));
        graph.addEdge(new Edge(1, 3, 0.29));
        graph.addEdge(new Edge(2, 7, 0.34));
        graph.addEdge(new Edge(6, 2, 0.40));
        graph.addEdge(new Edge(3, 6, 0.52));
        graph.addEdge(new Edge(6, 0, 0.58));
        graph.addEdge(new Edge(6, 4, 0.93));
        //创建一个KruskalMST对象,计算加权无向图中的最小生成树
        KruskalMST primMST = new KruskalMST(graph);

        //获取最小生成树中的所有边
        MyArrayQueue<Edge> edges = primMST.edges();
        //遍历打印所有的边
        for (int i = 0; i < edges.length(); i++) {
            Edge edge = edges.get(i);
            int v = edge.either();
            int w = edge.other(v);
            System.out.println(v + "-" + w + " :: " + edge.weight());
        }
    }
}
四 最短路径
例如在一副地图中,找到顶点a与地点b之间的路径,这条路径可以是距离最短,也可以是时间最短,也可以是费用最小等,如果我们把 距离/时间/费用看做是成本,那么就需要找到地点a和地点b之间成本最小的路径,也就是我们接下来要解决的最短路径问题.
4.1 最短路径概念
在一副加权有向图中,从顶点s到顶点t的最短路径是所有从顶点s到顶点t的路径中总权重最小的那条路径。
性质:
- 路径具有方向性;
- 权重不一定等价于距离。权重可以是距离、时间、花费等内容,权重最小指的是成本最低
- 只考虑连通图。一副图中并不是所有的顶点都是可达的,如果s和t不可达,那么它们之间也就不存在最短路径,为了简化问题,这里只考虑连通图。
- 最短路径不一定是唯一的。从一个顶点到达另外一个顶点的权重最小的路径可能会有很多条,这里只需要找出一
条即可。
最短路径树:
给定一副加权有向图和一个顶点s,以s为起点的一棵最短路径树是图的一副子图,它包含顶点s以及从s可达的所有顶点。这棵有向树的根结点为s,树的每条路径都是有向图中的一条最短路径。
4.2 Dijstra算法
4.2.1 实现原理
4.2.2 代码实现
package com.ycc.data.structure.graph;

import com.ycc.data.structure.heap.IndexMinPriorityQueue;
import com.ycc.data.structure.line.MyArrayQueue;

/**
 * 最短路径
 *
 * @author hezhaoming
 * @date 2020/10/19
 */
public class DijkstraSP {
    //索引代表顶点,值表示从顶点s到当前顶点的最短路径上的最后一条边
    private DirectedEdge[] edgeTo;
    //索引代表顶点,值从顶点s到当前顶点的最短路径的总权重
    private double[] distTo;
    //存放树中顶点与非树中顶点之间的有效横切边
    private IndexMinPriorityQueue<Double> pq;

    //根据一副加权有向图G和顶点s,创建一个计算顶点为s的最短路径树对象
    public DijkstraSP(EdgeWeightedDigraph G, int s) {
        //初始化edgeTo
        this.edgeTo = new DirectedEdge[G.V()];
        //初始化distTo
        this.distTo = new double[G.V()];
        for (int i = 0; i < distTo.length; i++) {
            distTo[i] = Double.POSITIVE_INFINITY;
        }
        //初始化pq
        this.pq = new IndexMinPriorityQueue<>(G.V());
        //找到图G中以顶点s为起点的最短路径树
        //默认让顶点s进入到最短路径树中
        distTo[s] = 0.0;
        pq.insert(s, 0.0);
        //遍历pq
        while (!pq.isEmpty()) {
            relax(G, pq.delMin());
        }
    }

    //松弛图G中的顶点v
    private void relax(EdgeWeightedDigraph G, int v) {
        MyArrayQueue<DirectedEdge> arrayQueue = G.adj(v);
        for (int i = 0; i < arrayQueue.length(); i++) {
            DirectedEdge edge = arrayQueue.get(i);
            //获取到该边的终点w
            int w = edge.to();
            //通过松弛技术,判断从起点s到顶点w的最短路径是否需要先从顶点s到顶点v,然后再由顶点v到顶点w
            if (distTo(v) + edge.weight() < distTo(w)) {
                distTo[w] = distTo[v] + edge.weight();
                edgeTo[w] = edge;
                //判断pq中是否已经存在顶点w,如果存在,则更新权重,如果不存在,则直接添加
                if (pq.contains(w)) {
                    pq.changeItem(w, distTo(w));
                } else {
                    pq.insert(w, distTo(w));
                }

            }
        }
    }

    //获取从顶点s到顶点v的最短路径的总权重
    public double distTo(int v) {
        return distTo[v];
    }

    //判断从顶点s到顶点v是否可达
    public boolean hasPathTo(int v) {
        return distTo[v] < Double.POSITIVE_INFINITY;
    }

    //查询从起点s到顶点v的最短路径中所有的边
    public MyArrayQueue<DirectedEdge> pathTo(int v) {
        //判断从顶点s到顶点v是否可达,如果不可达,直接返回null
        if (!hasPathTo(v)) {
            return null;
        }
        //创建队列对象
        MyArrayQueue<DirectedEdge> allEdges = new MyArrayQueue<>();
        while (true) {
            DirectedEdge e = edgeTo[v];
            if (e == null) {
                break;
            }
            allEdges.enQueue(e);
            v = e.from();
        }

        return allEdges;
    }

}
4.2.3 测试代码
package com.ycc.data.structure.graph.test;


import com.ycc.data.structure.graph.DijkstraSP;
import com.ycc.data.structure.graph.DirectedEdge;
import com.ycc.data.structure.graph.EdgeWeightedDigraph;
import com.ycc.data.structure.line.MyArrayQueue;

public class DijkstraSPTest {

    public static void main(String[] args) throws Exception {
        //8
        //15
        //4 5 0.35
        //5 4 0.35
        //4 7 0.37
        //5 7 0.28
        //7 5 0.28
        //5 1 0.32
        //0 4 0.38
        //0 2 0.26
        //7 3 0.39
        //1 3 0.29
        //2 7 0.34
        //6 2 0.40
        //3 6 0.52
        //6 0 0.58
        //6 4 0.93
        EdgeWeightedDigraph digraph = new EdgeWeightedDigraph(8);
        digraph.addEdge(new DirectedEdge(4, 5, 0.35));
        digraph.addEdge(new DirectedEdge(5, 4, 0.35));
        digraph.addEdge(new DirectedEdge(4, 7, 0.37));
        digraph.addEdge(new DirectedEdge(5, 7, 0.28));
        digraph.addEdge(new DirectedEdge(7, 5, 0.28));
        digraph.addEdge(new DirectedEdge(5, 1, 0.32));
        digraph.addEdge(new DirectedEdge(0, 4, 0.38));
        digraph.addEdge(new DirectedEdge(0, 2, 0.26));
        digraph.addEdge(new DirectedEdge(7, 3, 0.39));
        digraph.addEdge(new DirectedEdge(1, 3, 0.29));
        digraph.addEdge(new DirectedEdge(2, 7, 0.34));
        digraph.addEdge(new DirectedEdge(6, 2, 0.40));
        digraph.addEdge(new DirectedEdge(3, 6, 0.52));
        digraph.addEdge(new DirectedEdge(6, 0, 0.58));
        digraph.addEdge(new DirectedEdge(6, 4, 0.93));
        //创建DijkstraSP对象,查找最短路径树
        DijkstraSP dijkstraSP = new DijkstraSP(digraph, 0);
        //查找最短路径,0->6的最短路径
        MyArrayQueue<DirectedEdge> edges = dijkstraSP.pathTo(6);

        //遍历打印所有的边
        for (int i = 0; i < edges.length(); i++) {
            DirectedEdge edge = edges.get(i);
            System.out.println(edge.from() + "->" + edge.to() + " :: " + edge.weight());
        }

    }
}

若有收获,就点个赞吧
0 人点赞


