介绍
随着表中行数的增多,管理和性能性能影响也将随之增加。备份将要花费更多时间,恢复也将 要花费更说的时间,对整个数据表的查询也将花费更多时间。通过把一个表中的行分为几个部分,可以减少大型表的管理和性能问题,以这种方式划分发表数据的方法称为对表的分区。分区表的优势:
(1)改善查询性能:对分区对象的查询可以仅搜索自己关心的分区,提高检索速度;
(2)方便数据管理:因为分区表的数据存储在多个部分中,所以按分区加载和删除数据比在大表中加载和删除数据更容易;
(3)方便备份恢复:因为分区比被分区的表要小,所以针对分区的备份和恢复方法要比备份和恢复整个表的方法多。
12R2新特性
1.非分区表可以在线转换成分区表
2.列表的分区现在支持多列
3.复合分区表的子分区可以采用列表分区的方式
4.分区和子分区可以设置成只读模式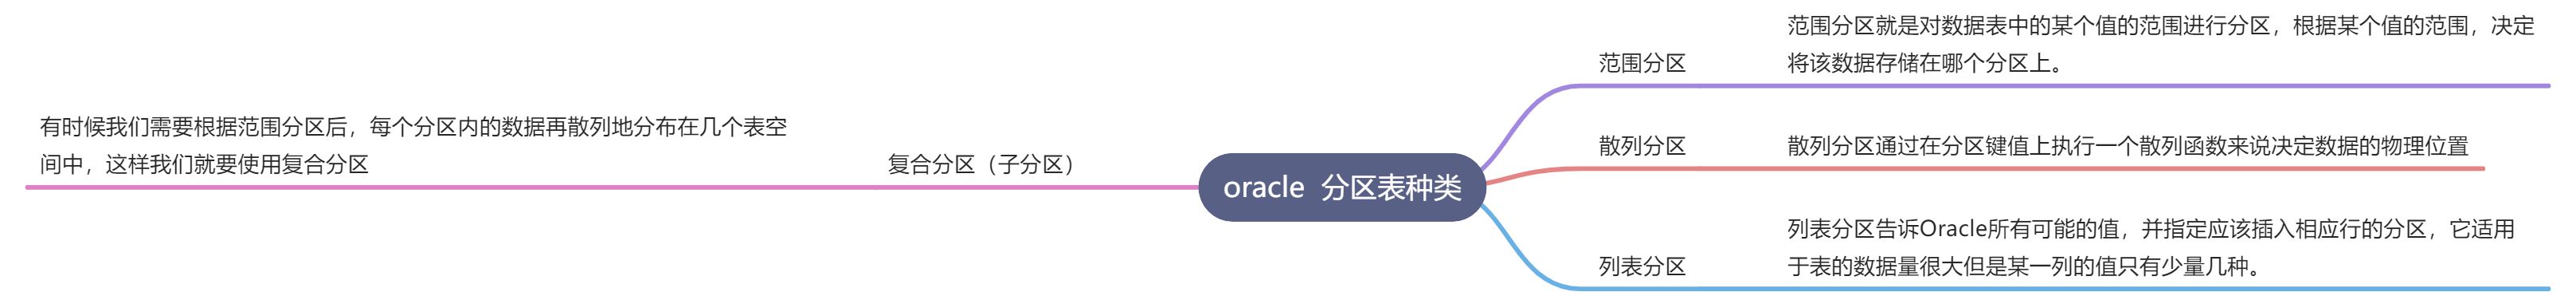
| 分区 | —查询表上有多少分区:SELECT FROM USER_TAB_PARTITIONS WHERE TABLE_NAME=’tableName’ —显示表分区信息 显示数据库所有分区表的详细分区信息:select from DBA_TAB_PARTITIONS —显示当前用户可访问的所有分区表的详细分区信息:select from ALL_TAB_PARTITIONS —显示当前用户所有分区表的详细分区信息:select from USER_TAB_PARTITIONS |
|---|---|
| 子分区 | —显示子分区信息 显示数据库所有组合分区表的子分区信息:select from DBA_TAB_SUBPARTITIONS —显示当前用户可访问的所有组合分区表的子分区信息:select from ALL_TAB_SUBPARTITIONS —显示当前用户所有组合分区表的子分区信息:select * from USER_TAB_SUBPARTITIONS |
| 分区表 | —显示数据库所有分区表的信息:select from DBA_PART_TABLES where table_name=upper(‘dinya_test’) —显示当前用户可访问的所有分区表信息:select from ALL_PART_TABLES —显示当前用户所有分区表的信息:select * from USER_PART_TABLES |
| 分区列 | —显示分区列 显示数据库所有分区表的分区列信息:select from DBA_PART_KEY_COLUMNS —显示当前用户可访问的所有分区表的分区列信息:select from ALL_PART_KEY_COLUMNS —显示当前用户所有分区表的分区列信息:select * from USER_PART_KEY_COLUMNS |
| 子分区列 | —显示子分区列 显示数据库所有分区表的子分区列信息:select from DBA_SUBPART_KEY_COLUMNS —显示当前用户可访问的所有分区表的子分区列信息:select from ALL_SUBPART_KEY_COLUMNS —显示当前用户所有分区表的子分区列信息:select * from USER_SUBPART_KEY_COLUMNS |
| 特例 | —怎样查询出oracle数据库中所有的的分区表:select * from user_tables a where a.partitioned=’YES’ |
实例演示Oracle对表或索引的分区操作
表
1.创建表空间
create TABLESPACE job_part1 datafile size 10m;create TABLESPACE job_part2 datafile size 10m;create TABLESPACE job_part3 datafile size 10m;create TABLESPACE job_part4 datafile size 10m;
2.建表
------范围分区-----------CREATE TABLE MOCKDATA(ID INT,JobTitle VARCHAR(500),EmailAddress VARCHAR(500),FirstNameLastName VARCHAR(500),induct DATE)partition by range(induct)(partition induction2016 values less than (to_date('2016-01-01 00:00:00','yyyy-mm-dd hh24:mi:ss')) tablespace job_part1 ,partition induction2017 values less than (to_date('2017-01-01 00:00:00','yyyy-mm-dd hh24:mi:ss')) tablespace job_part2,partition induction2018 values less than (to_date('2018-01-01 00:00:00','yyyy-mm-dd hh24:mi:ss')) tablespace job_part3,partition induction2019 values less than (to_date('2019-01-01 00:00:00','yyyy-mm-dd hh24:mi:ss')) tablespace job_part4);-----------hash (散列)分区-----------------CREATE TABLE MOCKDATA1(ID INT,JobTitle VARCHAR(500),EmailAddress VARCHAR(500),FirstNameLastName VARCHAR(500),induct DATE)partition by hash(id)(partition part1 tablespace job_part1 ,partition part2 tablespace job_part2,partition part3 tablespace job_part3,partition part4 tablespace job_part4);------------------list列表分区-------------------CREATE TABLE MOCKDATA2(ID INT,JobTitle VARCHAR(500),EmailAddress VARCHAR(500),FirstNameLastName VARCHAR(500),induct DATE)partition by list(id)(partition part1 values(500,100) tablespace job_part1 ,partition part2 values(200,300) tablespace job_part2,partition part3 values(400,800) tablespace job_part3,partition part4 values(DEFAULT)tablespace job_part4);12CR2之后列表分区自动创建新分区CREATE TABLE enmotech (PartID integer not null,CretTm date not null,PartCD varchar2(2) not null) partition by list (partcd) automatic (partition pBJ values ('BJ'),partition pCD values ('CD'),partition pGZ values ('GZ'),partition pSH values ('SH'));---------------------复合分区(子分区)-------------------------------CREATE TABLE MOCKDATA(ID INT,JobTitle VARCHAR(500),EmailAddress VARCHAR(500),FirstNameLastName VARCHAR(500),induct DATE)partition by range(induct) SUBPARTITION by list(id)(partition induction2016 values less than (to_date('2016-01-01 00:00:00','yyyy-mm-dd hh24:mi:ss')) tablespace job_part1( subpartition subinduction2016_100 values (100) tablespace job_part2 ,subpartition subinduction2016_200 values (200) tablespace job_part3 ),partition induction2017 values less than (to_date('2017-01-01 00:00:00','yyyy-mm-dd hh24:mi:ss')) tablespace job_part2(subpartition induction2017_400 values(400) tablespace job_part2,subpartition induction2017_500 values(500)tablespace job_part3));
3.插入数据
INSERT INTO MOCKDATA VALUES('1','Global Logistics Supervisor','Angela_Callan6585@extex.org','Angela Callan',to_date('2018-08-26 11:39:56','yyyy-mm-dd hh24:mi:ss'));
INSERT INTO MOCKDATA VALUES('2','Audiologist','Cassandra_Plant6847@corti.com',to_date('Cassandra Plant','2016-07-12 02:14:23','yyyy-mm-dd hh24:mi:ss'));
INSERT INTO MOCKDATA VALUES('3','Food Technologist','Benny_Ward9267@atink.com','Benny Ward',to_date('2017-03-09 15:32:45','yyyy-mm-dd hh24:mi:ss'));
INSERT INTO MOCKDATA VALUES('4','Pharmacist','Joy_Vane351@zorer.org','Joy Vane',to_date('2019-08-15 22:21:58','yyyy-mm-dd hh24:mi:ss'));
INSERT INTO MOCKDATA VALUES('5','Machine Operator','Caitlyn_Plant1881@bauros.bi','Caitlyn Plant',to_date('2018-05-17 05:34:30','yyyy-mm-dd hh24:mi:ss'));
INSERT INTO MOCKDATA VALUES('6','CNC Operator','Rick_Gilmore2772@nimogy.bi','Rick Gilmore',to_date('2017-02-02 01:00:30','yyyy-mm-dd hh24:mi:ss'));
INSERT INTO MOCKDATA VALUES('7','HR Coordinator','Davina_Doherty3802@sveldo.bi','Davina Doherty',to_date('2020-01-27 05:11:47','yyyy-mm-dd hh24:mi:ss'));
INSERT INTO MOCKDATA VALUES('8','Mobile Developer','Julian_Lee8630@kideod.bi','Julian Lee',to_date('2017-09-05 07:43:09','yyyy-mm-dd hh24:mi:ss'));
4.查询数据
select  *  from MOCKDATA PARTITION(induction2018); #指定分区
select  *  from MOCKDATA subPARTITION(induction2018);  #指定子分区
select  *  from MOCKDATA ;#不指定分区
5.更改表数据
update MOCKDATA PARTITION(induction2018)  set jobtitle='food'   where id=3; #指定分区
update MOCKDATA   set jobtitle='food'   where id=3;  #不指定分区
6.删除数据
delete MOCKDATA PARTITION(induction2018) ;   #删除指定分区所有数据
delete   MOCKDATA  where id=3;
7.查询特定表拥有的分区
select * from user_tab_subpartitions where table_name =upper('MOCKDATA');
8.添加分区
#添加分区
ALTER TABLE MOCKDATA ADD PARTITION P3 VALUES LESS THAN(TO_DATE('2003-06-01','YYYY-MM-DD')) tablespace job_part5;
#添加子分区
ALTER TABLE MOCKDATA MODIFY PARTITION P3 ADD SUBPARTITION P3SUB1 VALUES('COMPLETE') tablespace job_part6;
#在线添加分区不会锁表
alter table emp MODIFY
PARTITION BY RANGE (id) INTERVAL(1000)
      (PARTITION p1 VALUES LESS THAN (1000),
       PARTITION P2 VALUES LESS THAN (2000))ONLINE;
9.删除分区
ALTER TABLE SALES DROP SUBPARTITION P4SUB1;#删除子分区
ALTER TABLE SALES DROP PARTITION P3; #删除分区
10.截断分区
截断某个分区是指删除某个分区中的数据,并不会删除分区,也不会删除其它分区中的数据,注意12c之后截断分区会执行cascade功能,全局索引不在无效并自动管理
ALTER TABLE SALES TRUNCATE PARTITION P2;
11.合并分区
不能将分区合并到界限较低的分区
ALTER TABLE SALES MERGE PARTITIONS P1,P2 INTO PARTITION P2;
12.拆分分区
不能对HASH类型的分区进行拆分
注意:拆分分区后之前的分区物理段会被完全废弃,索引也必须重建
ALTER TABLE SALES SBLIT PARTITION P2 AT(TO_DATE('2003-02-01','YYYY-MM-DD')) INTO (PARTITION P21,PARTITION P22);
13.接合分区(coalesca)
结合分区是将散列分区中的数据接合到其它分区中,当散列分区中的数据比较大时,可以增加散列分区,接合分区只能用于散列分区中
ALTER TABLE SALES COALESCA PARTITION;
14.重命名表分区
ALTER TABLE SALES RENAME PARTITION P21 TO P2;
15.移动表分区
NOLOGGING 选项禁止在移动过程中产生重做日志,加快移动速度.
alter table dept move partition d3 tablespace d4 nologging;
索引
在分区表上可以建立三种类型的索引:1和普通表一样的全局索引;2.全局分区索引;3.本地分区索引
1建立普通的索引
create index index_fraction on range_fraction(fraction);
2.建立本地分区索引
(就是一个索引分区只能对应一个表分区)
create index  local_index_emp on emp(id) local
(partition d1 tablespace dept1,
partition d2 tablespace dept2);
3.建立全局分区索引
(属于散列索引分区,就是一个索引分区可能指向多个表分区)
create UNIQUE index global_index_emp on emp(id)
GLOBAL PARTITION BY RANGE (id)
      (PARTITION p1 VALUES LESS THAN (1000),
       PARTITION p2 VALUES LESS THAN (2000),
       PARTITION p3 VALUES LESS THAN (MAXVALUE)
      );
4.重建制定分区索引
alter index  LOCAL_INDEX_EMP REBUILD PARTITION p1;   #重建制定分区索引
alter index  LOCAL_INDEX_EMP     MODIFY   PARTITION p1  UNUSABLE;#修改制定分区索引不可用
5.相关视图
select  *  from dba_ind_partitions;
select  *  from dba_ind_pending_stats;

若有收获,就点个赞吧
0 人点赞


