数据如何传输
概述:
大圈对大圈(电脑找IP地址)小圈対小圈(软件找端口)说话都一样(定义通讯规则)我打包你来拆(数据传输模型)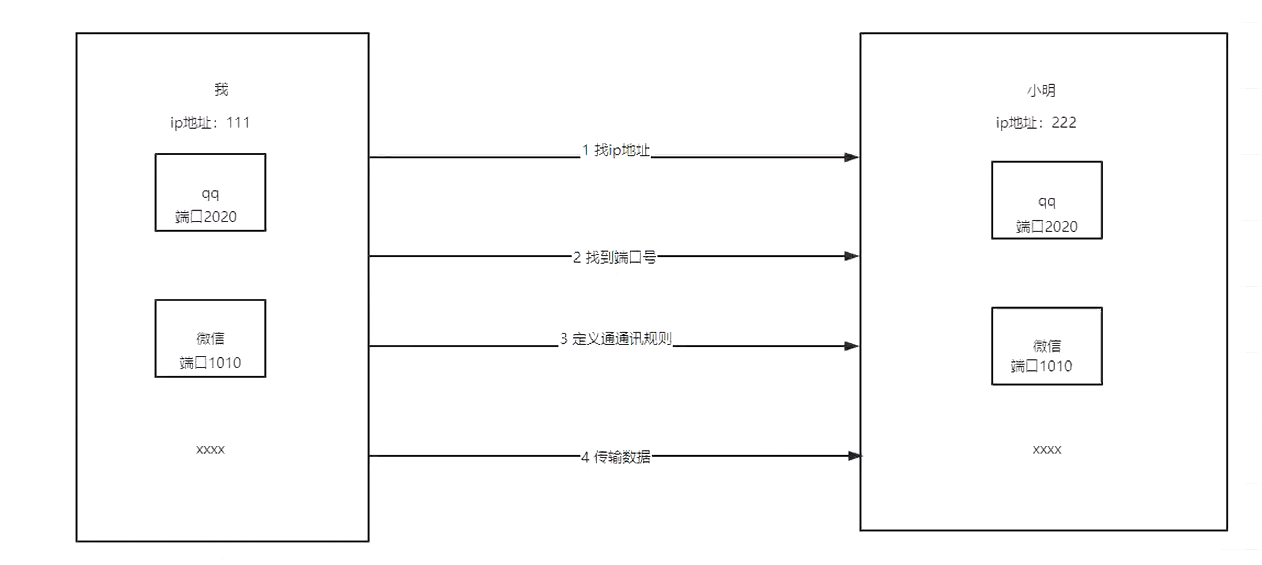
ip地址
作用:电脑的身份证,通过ip唯一确定一个设备 数据可以发送到电脑上
特点:1.不可重复:一个ip有且只有一个
2.可以改变:一个电脑在不同地方会有不同的ip。
端口
含义:数据发送给电脑后,通过数字标识发送到指定程序上,这些数字标识叫做端口
常用端口号:
mongodb 27017
mysql 3306
http 80
https 443
通讯规则
TCP/IP:国际组织定义的通讯协议。
http协议 :HTTP(HpperText Transfer Protocol),即超文本传输协议,是互联网上应用广泛的一种网络协议,html是超文本标记语言,http是用来传输html的协议。https协议 http + ssl(安全传输协议)。
HTTP协议常用的请求方法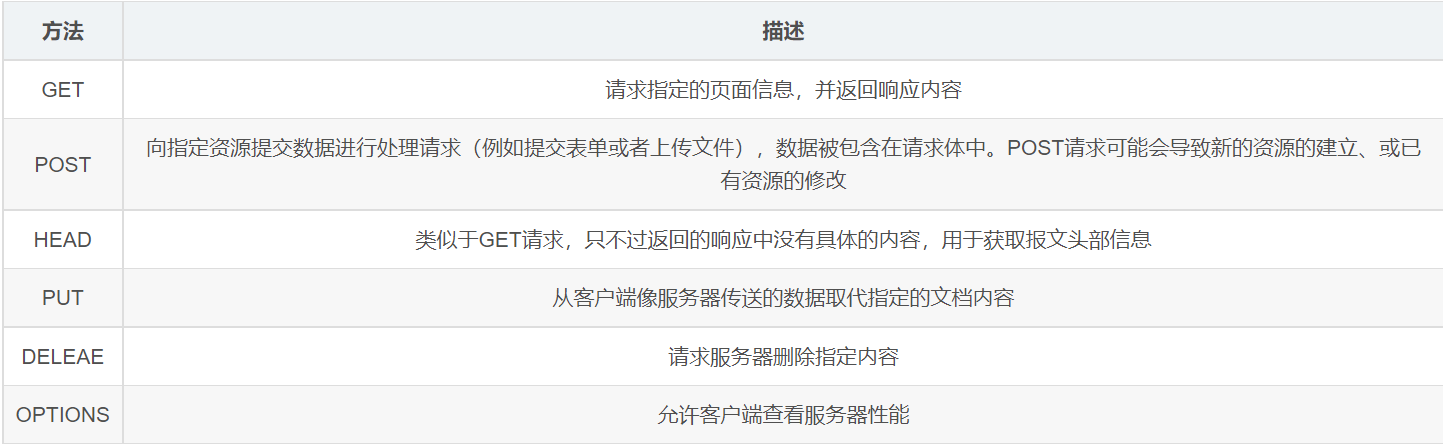
HTTP状态码及其含义
200 : 请求成功
301 : 永久重定向
302 : 临时重定向
404 : 请求失败(服务器无法根据客户端的请求找到资源(网页))
403:禁止访问 服务器可能已经检查出来你是爬虫了
500 : 服务器内部请求
503:服务不可用
例如:状态码200,表示请求成功完成,状态码404,表示服务器找不到给定的资源。
数据传输模型
我们要传递的信息需要经过层层封包才可以传输,传输到另一台设备的数据需要经过层层拆包才可以转换成人可以读的语言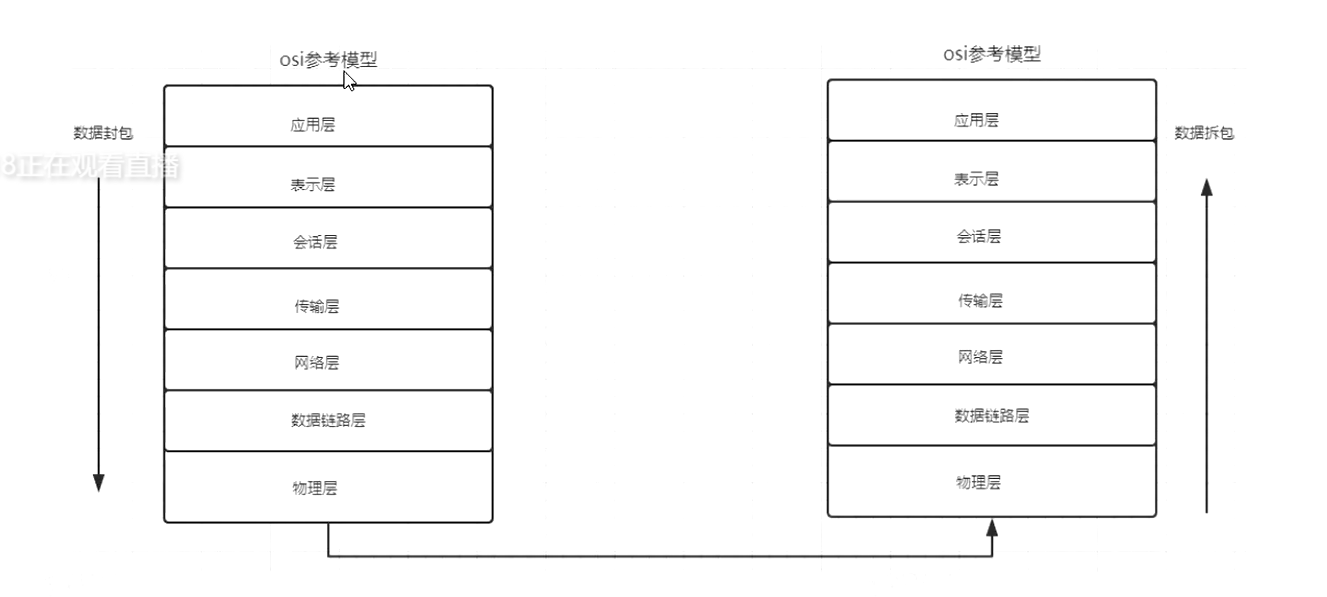<br />七层太麻烦之后转化成四层<br />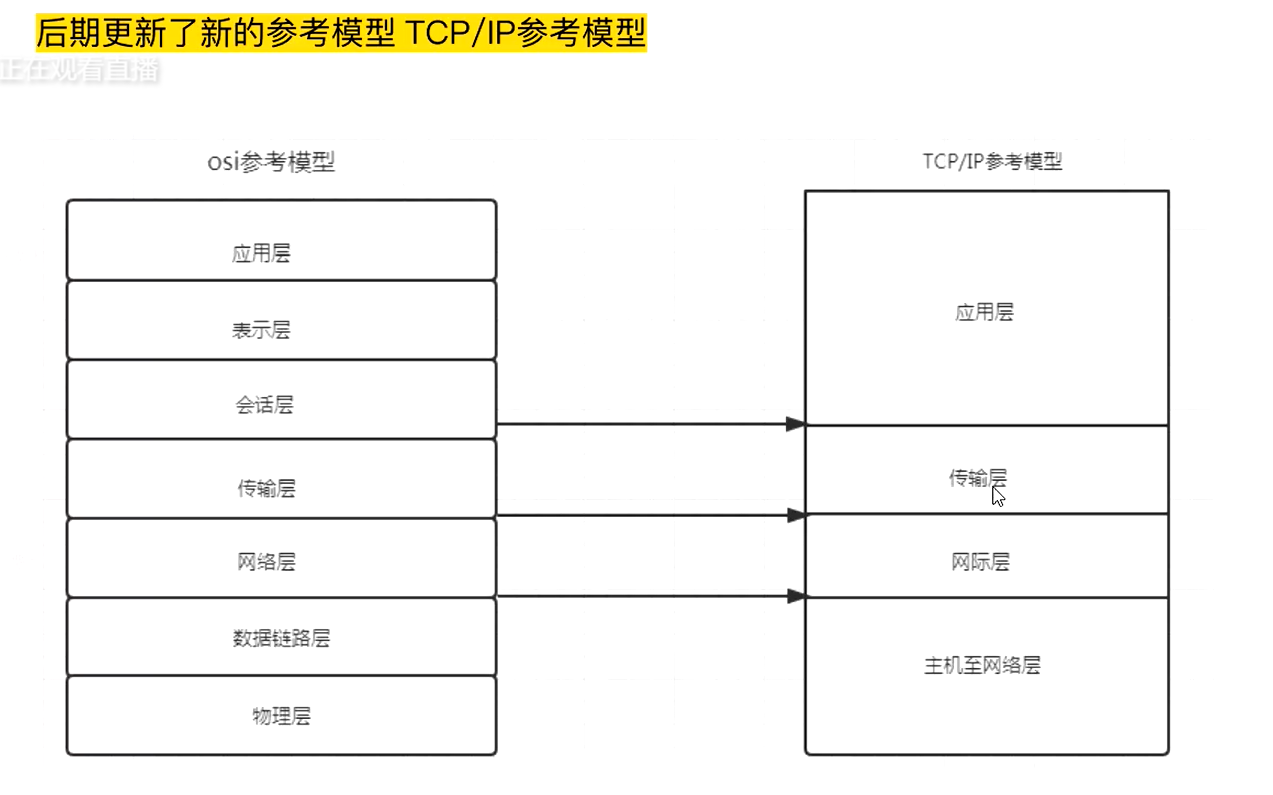<br />注意:http,https,ssl是在应用层
HTTP请求与响应
 过程概述
- 当用户在浏览器的地址栏中输入一个URL并按回车键之后,浏览器会向HTTP服务器发送HTTP请求。HTTP请求主要分为“Get”和“Post”两种方法。(GET : 查询参数都会在URL上显示出来,POST : 查询参数和需要提交数据是隐藏在Form表单里的,不会在URL地址上显示出来)
- 当我们在浏览器输入URL http://www.baidu.com 的时候,浏览器发送一个Request请求去获取 http://www.baidu.com 的html文件,服务器把Response文件对象发送回给浏览器。
- 浏览器分析Response中的 HTML,发现其中引用了很多其他文件,比如Images文件,CSS文件,JS文件。 浏览器会自动再次发送Request去获取图片,CSS文件,或者JS文件。
- 当所有的文件都下载成功后,网页会根据HTML语法结构,完整的显示出来了。
客户端请求
URL只是标识资源的位置,而HTTP是用来提交和获取资源。客户端发送一个HTTP请求到服务器的请求消息,包括以下格式:
请求行、请求头部、空行、请求数据
四个部分组成,下图给出了请求报文的一般格式。
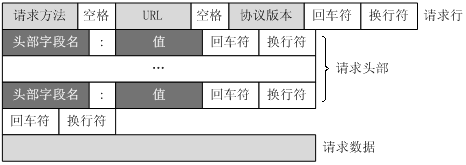
一个典型的HTTP请求示例
GET / HTTP/1.1Host: www.baidu.comConnection: keep-aliveCache-Control: max-age=0Upgrade-Insecure-Requests: 1User-Agent: Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/77.0.3865.75 Safari/537.36Sec-Fetch-Mode: navigateSec-Fetch-User: ?1Accept: text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,image/apng,*/*;q=0.8,application/signed-exchange;v=b3Sec-Fetch-Site: same-originReferer: https://www.baidu.com/s?ie=utf-8&f=8&rsv_bp=1&rsv_idx=1&tn=baidu&wd=Python%20%20%E6%89%8B%E5%8A%A8%E5%9B%9E%E6%94%B6%E5%9E%83%E5%9C%BE&oq=Python%2520%25E6%2594%25B6%25E5%2588%25B0%25E5%259B%259E%25E6%2594%25B6%25E5%259E%2583%25E5%259C%25BE&rsv_pq=f5baabda0010c033&rsv_t=1323wLC5312ORKIcfWo4JroXu16WSW5HqZ183yRWRnjWHaeeseiUUPIDun4&rqlang=cn&rsv_enter=1&rsv_dl=tb&inputT=2315&rsv_sug3=48&rsv_sug2=0&rsv_sug4=2736Accept-Encoding: gzip, deflate, brAccept-Language: zh-CN,zh;q=0.9Cookie: BIDUPSID=4049831E3DB8DE890DFFCA6103FF02C1;
抓包工具:学会查看浏览器的请求和响应(以谷歌百度为例)
步骤
- 在谷歌浏览器输入网址:www.biadu.com.进入百度官网
- 按下F12键(或单击鼠标右键选择”检查“选项),审查页面元素。
- 单击谷歌浏览器调试工具中“Network”选项,按下F5 键(或手动刷新页面),单击调试工具中的“Name”栏 目下的“www.baidu.com”,查看请求与响应信息,如下图所示。
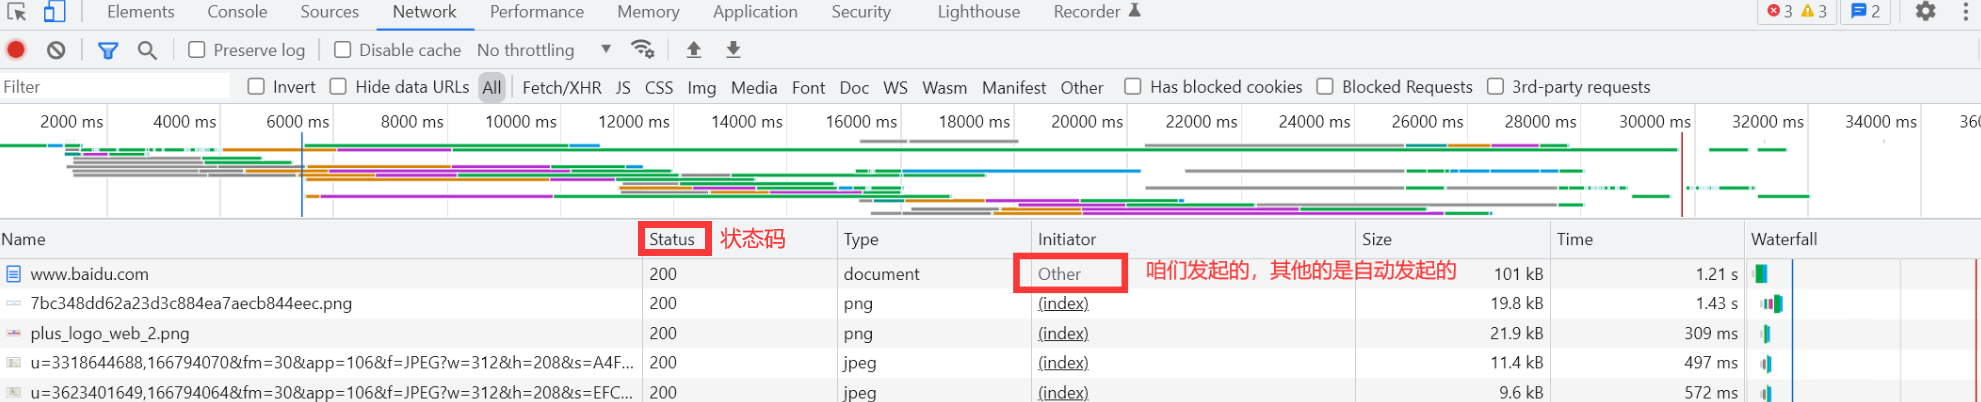
- 点击自己发起的请求,进入请求响应页面。
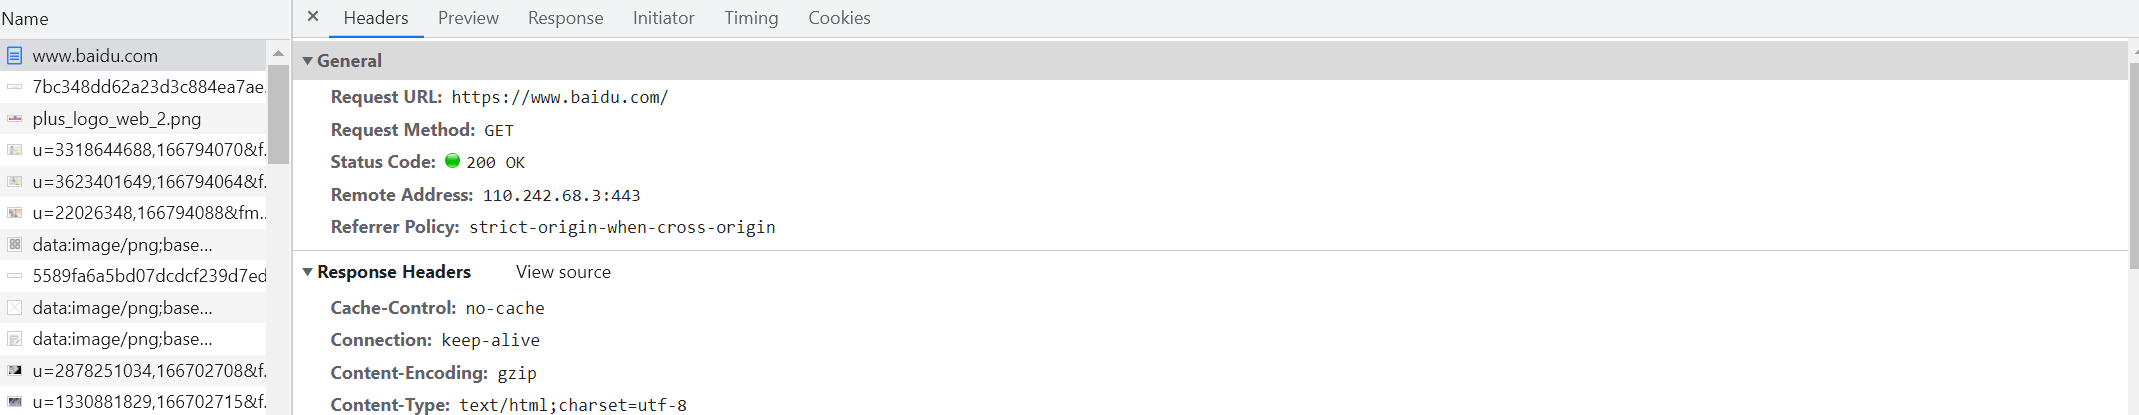
重要元素含义
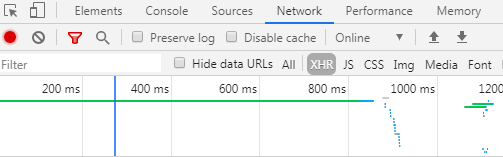
Elements : 元素 网页源代码,提取数据和分析数据(有些数据是经过特殊处理的所以并不是都是准确的),与正真的网络代码分开。
Console : 控制台 (打印信息),后期用于分析js
Sources : 信息来源 (整个网站加载的文件资源,后期用于分析js)
NetWork : 网络工作(信息抓包) 能够看到所有的客户端请求和服务器的响应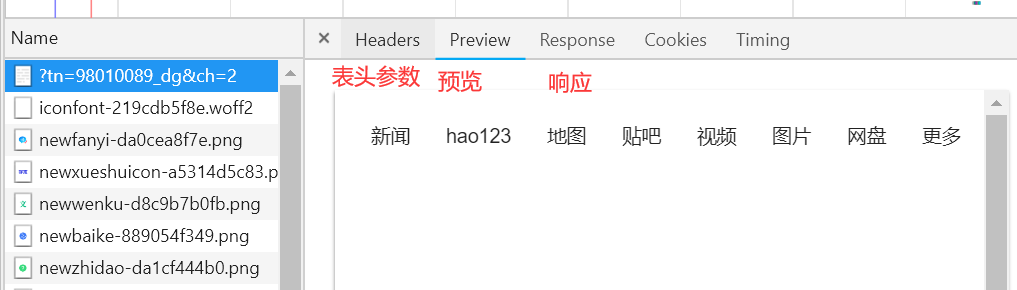
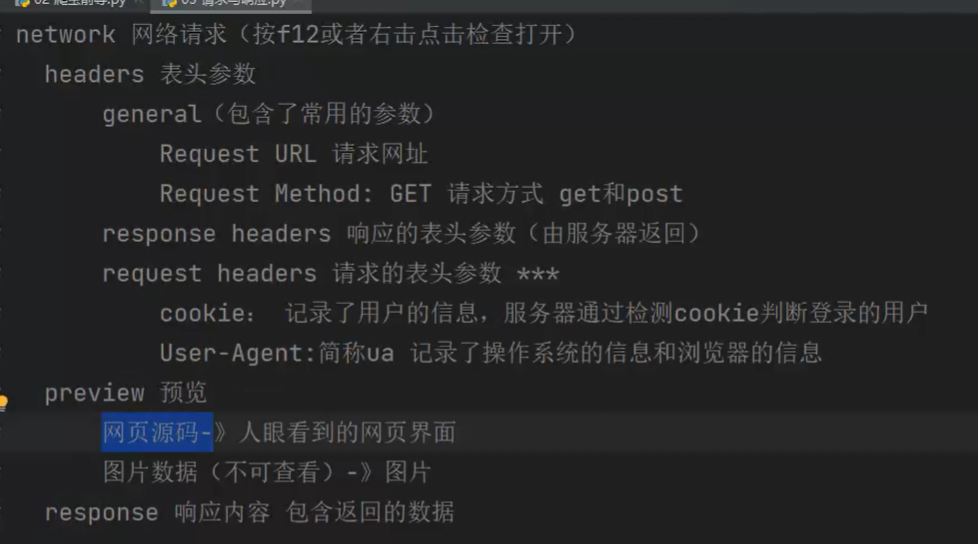
爬虫具体是啥么:用代码模拟浏览器,向服务器发出请求,获得相应模拟浏览器的模块url的基本构成
专业名字:统一资源定位符
基本模型:协议://域名/资源地址?网页参数#锚点
实例:https://www.baidu.com:443/s?wd=python#
https: 通讯协议
www.baidu.com 域名(对应主机的IP地址,地址复杂不好记 转成域名)
/s资源地址(地址可能不是一个/文号和域名之间的斜杠全是资源地址,即文件访问路径)
:443 协议的端口编号可以省略
?wd=python (重要参数决定了要找什么内容,还有其他参数但是不太重要甚至可以省略)
#锚点 用于定位到网页的一个位置
必要因素:协议和域名必不可少
注意 : 在浏览器请求一个url,浏览器会对这个 url 进行一个编码。(除英文字母、数字和部分标识其他的全部使用% 加 十六进制码进行编码)
例如 : https://tieba.baidu.com/f?ie=utf-8&kw=%E6%B5%B7%E8%B4%BC%E7%8E%8B&fr=search
%E6%B5%B7%E8%B4%BC%E7%8E%8B = 海贼王
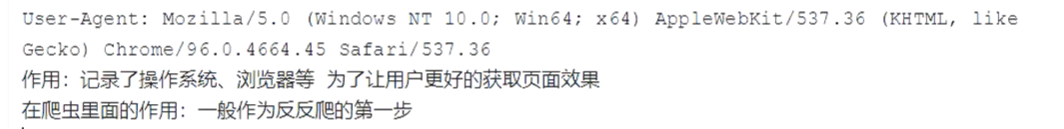
User—agent
Referer
防盗链,表明当前这个请求是从哪个url过来的,记录页面跳转。一般情况下可以用来做反爬的技术
Cookie
通过在客户端记录的信息确定用户身份,记录用户信息,用于反反爬,模拟登陆。
补充

若有收获,就点个赞吧
0 人点赞


