- 1 使用索引
- 1.1 建表SQL
- 1.2 案例(索引失效)
- 1.2.1 全值匹配我最爱
- 1.2.2 最佳左前缀法则
- 1.2.3 不要在索引列上做任何操作(计算、函数、(自动or手动)类型转换),会导致索引失效而转向全表扫描
- 1.2.4 存储引擎不能使用索引中范围条件右边的列
- 1.2.5 尽量使用覆盖索引(只访问索引的查询(索引列和查询列一致)),减少select *
- 1.2.6 MySQL 在使用不等于(!= 或者<>)的时候无法使用索引会导致全表扫描
- 1.2.7 is not null 也无法使用索引,但是is null是可以使用索引的
- 1.2.8 like以通配符开头(‘%abc…’),mysql索引失效会变成全表扫描的操作
- 1.2.9 字符串不加单引号索引失效
- 1.2.10 少用or,用它来连接时会索引失效
- 1.2.11 小总结
- 1.3 热身case
- 1.4 一般性建议
- 2 单表查询优化
1 使用索引
1.1 建表SQL
CREATE TABLE staffs (id INT PRIMARY KEY AUTO_INCREMENT,NAME VARCHAR (24) NOT NULL DEFAULT '' COMMENT '姓名',age INT NOT NULL DEFAULT 0 COMMENT '年龄',pos VARCHAR (20) NOT NULL DEFAULT '' COMMENT '职位',add_time TIMESTAMP NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '入职时间') DEFAULT CHARSET=utf8 COMMENT '员工记录表' ;INSERT INTO staffs(NAME,age,pos,add_time) VALUES('z3',22,'manager',NOW());INSERT INTO staffs(NAME,age,pos,add_time) VALUES('July',23,'dev',NOW());INSERT INTO staffs(NAME,age,pos,add_time) VALUES('2000',23,'dev',NOW());INSERT INTO staffs(NAME,age,pos,add_time) VALUES(null,23,'dev',NOW());SELECT * FROM staffs;ALTER TABLE staffs ADD INDEX idx_staffs_nameAgePos(name, age, pos);
1.2 案例(索引失效)
索引失效针对的组合索引? 若一个字段上有多种索引呢?某一索引失效,可以继续使用其他索引不影响。
1.2.1 全值匹配我最爱
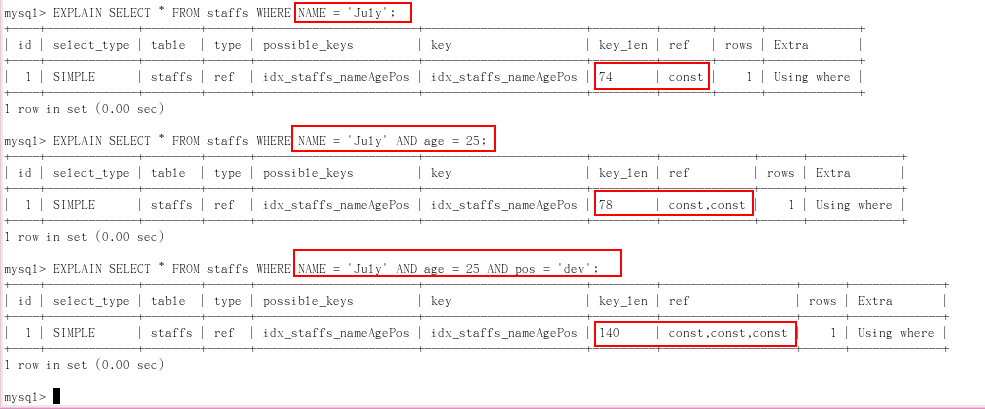
索引 idx_staffs_nameAgePos 建立索引时 以 name , age ,pos 的顺序建立的。全值匹配表示 按顺序匹配的
EXPLAIN SELECT * FROM staffs WHERE NAME = 'July';

EXPLAIN SELECT * FROM staffs WHERE NAME = 'July' AND age = 25;

EXPLAIN SELECT * FROM staffs WHERE NAME = 'July' AND age = 25 AND pos = 'dev';
1.2.2 最佳左前缀法则
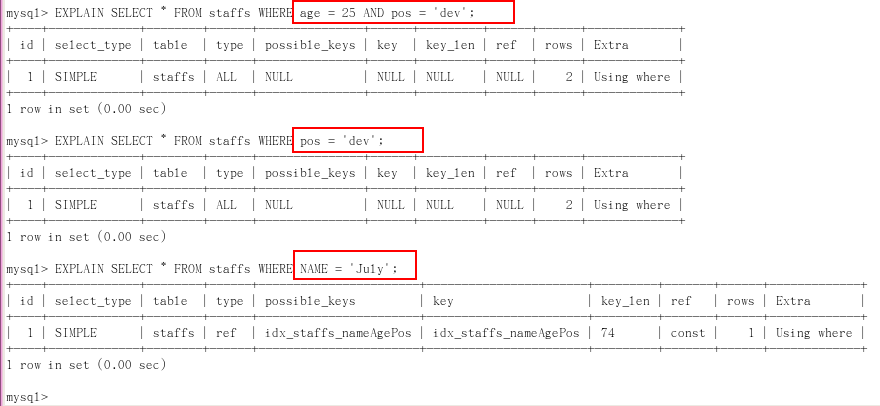
如果索引了多列,要遵守最左前缀法则。指的是查询从索引的最左前列开始并且不跳过索引中的列。
and 忽略左右关系。既即使没有没有按顺序 ,由于优化器的存在,会自动优化。
经过试验结论, 建立了 idx_nameAge 索引, id 为主键
1. 当使用覆盖索引的方式时,(select name/age/id from staffs where age=10 (后面没有其他没有索引的字段条件)),即使不是以 name 开头,也会使用 idx_nameAge 索引。

即 select 后的字段 有索引,where 后的字段也有索引,则无关执行顺序。

2. 除开上述条件 才满足最左前缀法则。
EXPLAIN SELECT * FROM staffs WHERE age = 25 AND pos = 'dev';

EXPLAIN SELECT * FROM staffs WHERE pos = 'dev';
1.2.3 不要在索引列上做任何操作(计算、函数、(自动or手动)类型转换),会导致索引失效而转向全表扫描
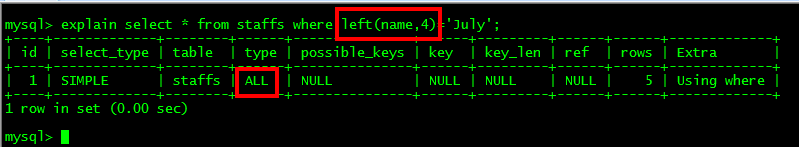
EXPLAIN SELECT * FROM staffs WHERE left(NAME,4) = 'July';
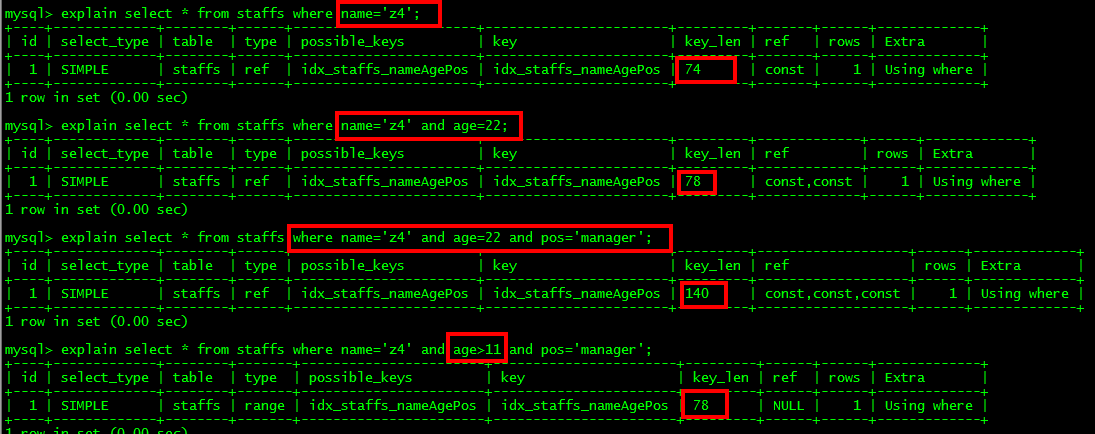
1.2.4 存储引擎不能使用索引中范围条件右边的列
范围 若有索引则能使用到索引,范围条件右边的索引会失效(范围条件右边与范围条件使用的同一个组合索引,右边的才会失效。若是不同索引则不会失效)
1.2.5 尽量使用覆盖索引(只访问索引的查询(索引列和查询列一致)),减少select *
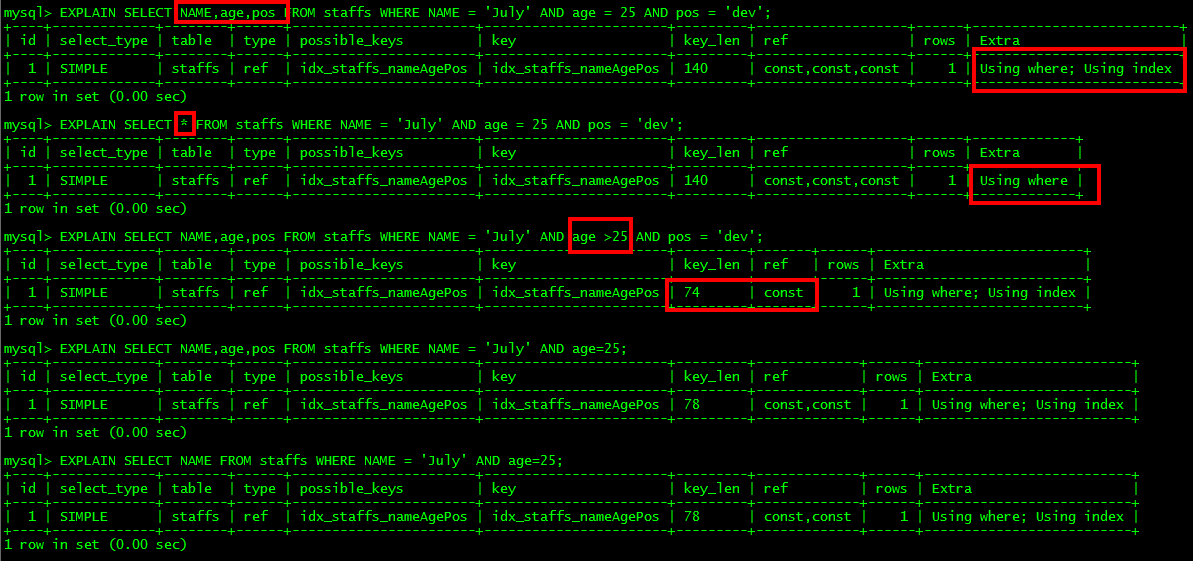
1.2.6 MySQL 在使用不等于(!= 或者<>)的时候无法使用索引会导致全表扫描
索引 idx_nameAgeJob
使用 != 和 <> 的字段索引失效( != 针对数值类型。 <> 针对字符类型)
where age != 10 and name=’xxx’ ,这种情况下,mysql自动优化,将 name=’xxx’ 放在 age !=10 之前,name 依然能使用索引。只是 age 的索引失效)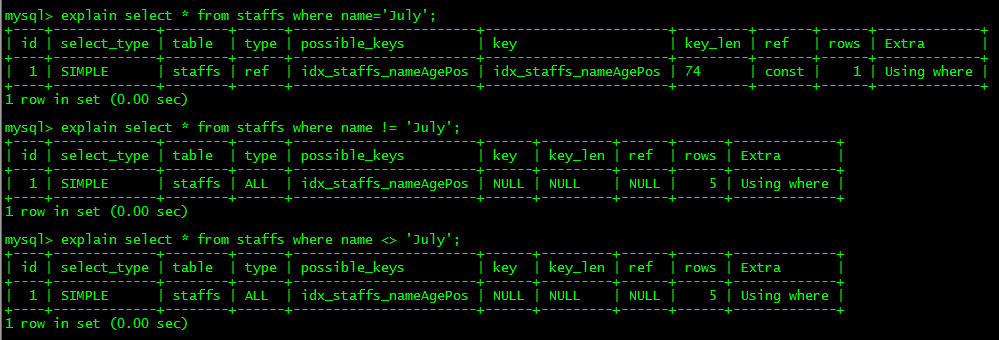
1.2.7 is not null 也无法使用索引,但是is null是可以使用索引的

1.2.8 like以通配符开头(‘%abc…’),mysql索引失效会变成全表扫描的操作
like ‘%abc%’ ,type 类型会变成 all
like ‘abc%’ type 类型为 range ,算是范围,可以使用索引

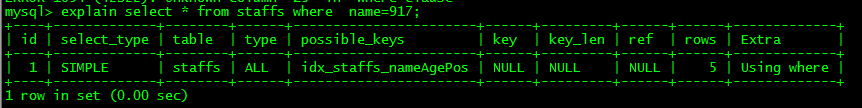
1.2.9 字符串不加单引号索引失效
底层进行转换使索引失效,使用了函数造成索引失效
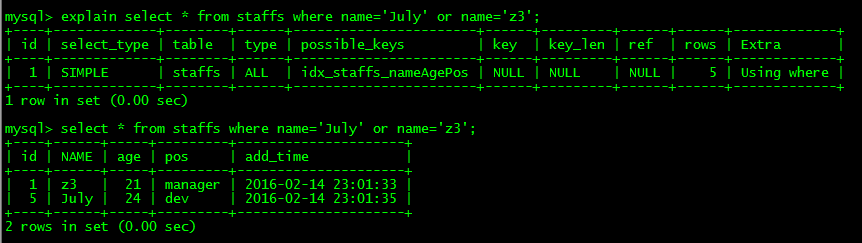
1.2.10 少用or,用它来连接时会索引失效
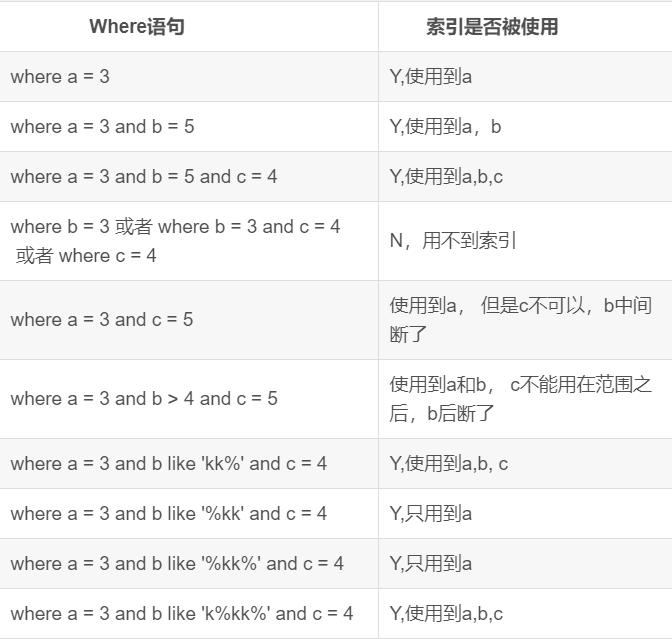
1.2.11 小总结
假设index(a,b,c)
1.3 热身case
【建表语句】
create table test03(
 id int primary key not null auto_increment,
 c1 char(10),
 c2 char(10),
 c3 char(10),
 c4 char(10),
 c5 char(10)
);
insert into test03(c1,c2,c3,c4,c5) values('a1','a2','a3','a4','a5');
insert into test03(c1,c2,c3,c4,c5) values('b1','b2','b3','b4','b5');
insert into test03(c1,c2,c3,c4,c5) values('c1','c2','c3','c4','c5');
insert into test03(c1,c2,c3,c4,c5) values('d1','d2','d3','d4','d5');
insert into test03(c1,c2,c3,c4,c5) values('e1','e2','e3','e4','e5');
select * from test03;
【建索引】
create index idx_test03_c1234 on test03(c1,c2,c3,c4);
show index from test03;
问题:我们创建了复合索引idx_test03_c1234 ,根据以下SQL分析下索引使用情况?
explain select * from test03 where c1='a1';
explain select * from test03 where c1='a1' and c2='a2';
explain select * from test03 where c1='a1' and c2='a2' and c3='a3';
explain select * from test03 where c1='a1' and c2='a2' and c3='a3' and c4='a4';
1)
 explain select * from test03 where c1='a1' and c2='a2' and c3='a3' and c4='a4';
2)
 explain select * from test03 where c1='a1' and c2='a2' and c4='a4' and c3='a3';
3)
 explain select * from test03 where c1='a1' and c2='a2' and c3>'a3' and c4='a4';
4)
 explain select * from test03 where c1='a1' and c2='a2' and c4>'a4' and c3='a3';
5)
 explain select * from test03 where c1='a1' and c2='a2' and c4='a4' order by c3;
 c3作用在排序而不是查找
6)
 explain select * from test03 where c1='a1' and c2='a2' order by c3;
7)
 explain select * from test03 where c1='a1' and c2='a2' order by c4;
出现了filesort
8)
8.1
 explain select * from test03 where c1='a1' and c5='a5' order by c2,c3;
 只用c1一个字段索引,但是c2、c3用于排序,无filesort
8.2
 explain select * from test03 where c1='a1' and c5='a5' order by c3,c2;
 出现了filesort,我们建的索引是1234,它没有按照顺序来,3 2 颠倒了
9)
 explain select * from test03 where c1='a1' and c2='a2' order by c2,c3;
10)
 explain select * from test03 where c1='a1' and c2='a2' and c5='a5' order by c2,c3;
用c1、c2两个字段索引,但是c2、c3用于排序,无filesort
 explain select * from test03 where c1='a1' and c2='a2' and c5='a5' order by c3,c2;
 本例有常量c2的情况,和8.2对比
 explain select * from test03 where c1='a1' and c5='a5' order by c3,c2;                     出现了filesort
11)
 explain select * from test03 where c1='a1' and c4='a4' group by c2,c3;
12)
 explain select * from test03 where c1='a1' and c4='a4' group by c3,c2;
 Using where; Using temporary; Using filesort
1.4 一般性建议
- 对于单键索引,尽量选择针对当前query过滤性更好的索引
- 在选择组合索引的时候,当前Query中过滤性最好的字段在索引字段顺序中,位置越靠前越好。(避免索引过滤性好的索引失效)
- 在选择组合索引的时候,尽量选择可以能够包含当前query中的where子句中更多字段的索引
- 尽可能通过分析统计信息和调整query的写法来达到选择合适索引的目的
2 单表查询优化
2.1 建表SQL
CREATE TABLE IF NOT EXISTS `article` (
`id` INT(10) UNSIGNED NOT NULL PRIMARY KEY AUTO_INCREMENT,
`author_id` INT(10) UNSIGNED NOT NULL,
`category_id` INT(10) UNSIGNED NOT NULL,
`views` INT(10) UNSIGNED NOT NULL,
`comments` INT(10) UNSIGNED NOT NULL,
`title` VARBINARY(255) NOT NULL,
`content` TEXT NOT NULL
);
INSERT INTO `article`(`author_id`, `category_id`, `views`, `comments`, `title`, `content`) VALUES
(1, 1, 1, 1, '1', '1'),
(2, 2, 2, 2, '2', '2'),
(1, 1, 3, 3, '3', '3');
SELECT * FROM article;
2.2 案例
- 查询 category_id 为1 且 comments 大于 1 的情况下,views 最多的 article_id。
EXPLAIN SELECT id,author_id FROM article WHERE category_id = 1 AND comments > 1 ORDER BY views DESC LIMIT 1;
- 结论:很显然,type 是 ALL,即最坏的情况。Extra 里还出现了 Using filesort,也是最坏的情况。优化是必须的。
开始优化:
1 新建索引+删除索引ALTER TABLE `article` ADD INDEX idx_article_ccv ( `category_id` , `comments`, `views` ); create index idx_article_ccv on article(category_id,comments,views); DROP INDEX idx_article_ccv ON article2 第2次EXPLAIN
EXPLAIN SELECT id,author_id FROM article WHERE category_id = 1 AND comments >1 ORDER BY views DESC LIMIT 1;
- 结论:
type 变成了 range,这是可以忍受的。但是 extra 里使用 Using filesort 仍是无法接受的。
但是我们已经建立了索引,为啥没用呢?
这是因为按照 B+Tree 索引的工作原理,先排序 category_id,如果遇到相同的 category_id 则再排序 comments,如果遇到相同的 comments 则再排序 views。当 comments 字段在联合索引里处于中间位置时,因comments > 1 条件是一个范围值(所谓 range),MySQL 无法利用索引再对后面的 views 部分进行检索,即 range 类型查询字段后面的索引无效。3 删除第一次建立的索引
DROP INDEX idx_article_ccv ON article;
4 第2次新建索引
ALTER TABLE `article` ADD INDEX idx_article_cv ( `category_id` , `views` ) ;
create index idx_article_cv on article(category_id,views);
5 第3次EXPLAIN
EXPLAIN SELECT id,author_id FROM article WHERE category_id = 1 AND comments > 1 ORDER BY views DESC LIMIT 1;
- 结论:可以看到,type 变为了 ref,Extra 中的 Using filesort 也消失了,结果非常理想。

    ```
    DROP INDEX idx_article_cv ON article;
    ```
3 关联查询优化
3.1 建表SQL
CREATE TABLE IF NOT EXISTS `class` (<br />`id` INT(10) UNSIGNED NOT NULL AUTO_INCREMENT,<br />`card` INT(10) UNSIGNED NOT NULL,<br />PRIMARY KEY (`id`)<br />);<br />CREATE TABLE IF NOT EXISTS `book` (<br />`bookid` INT(10) UNSIGNED NOT NULL AUTO_INCREMENT,<br />`card` INT(10) UNSIGNED NOT NULL,<br />PRIMARY KEY (`bookid`)<br />);<br />INSERT INTO class(card) VALUES(FLOOR(1 + (RAND() * 20)));<br />INSERT INTO class(card) VALUES(FLOOR(1 + (RAND() * 20)));<br />INSERT INTO class(card) VALUES(FLOOR(1 + (RAND() * 20)));<br />INSERT INTO class(card) VALUES(FLOOR(1 + (RAND() * 20)));<br />INSERT INTO class(card) VALUES(FLOOR(1 + (RAND() * 20)));<br />INSERT INTO class(card) VALUES(FLOOR(1 + (RAND() * 20)));<br />INSERT INTO class(card) VALUES(FLOOR(1 + (RAND() * 20)));<br />INSERT INTO class(card) VALUES(FLOOR(1 + (RAND() * 20)));<br />INSERT INTO class(card) VALUES(FLOOR(1 + (RAND() * 20)));<br />INSERT INTO class(card) VALUES(FLOOR(1 + (RAND() * 20)));<br />INSERT INTO class(card) VALUES(FLOOR(1 + (RAND() * 20)));<br />INSERT INTO class(card) VALUES(FLOOR(1 + (RAND() * 20)));<br />INSERT INTO class(card) VALUES(FLOOR(1 + (RAND() * 20)));<br />INSERT INTO class(card) VALUES(FLOOR(1 + (RAND() * 20)));<br />INSERT INTO class(card) VALUES(FLOOR(1 + (RAND() * 20)));<br />INSERT INTO class(card) VALUES(FLOOR(1 + (RAND() * 20)));<br />INSERT INTO class(card) VALUES(FLOOR(1 + (RAND() * 20)));<br />INSERT INTO class(card) VALUES(FLOOR(1 + (RAND() * 20)));<br />INSERT INTO class(card) VALUES(FLOOR(1 + (RAND() * 20)));<br />INSERT INTO class(card) VALUES(FLOOR(1 + (RAND() * 20)));<br />INSERT INTO book(card) VALUES(FLOOR(1 + (RAND() * 20)));<br />INSERT INTO book(card) VALUES(FLOOR(1 + (RAND() * 20)));<br />INSERT INTO book(card) VALUES(FLOOR(1 + (RAND() * 20)));<br />INSERT INTO book(card) VALUES(FLOOR(1 + (RAND() * 20)));<br />INSERT INTO book(card) VALUES(FLOOR(1 + (RAND() * 20)));<br />INSERT INTO book(card) VALUES(FLOOR(1 + (RAND() * 20)));<br />INSERT INTO book(card) VALUES(FLOOR(1 + (RAND() * 20)));<br />INSERT INTO book(card) VALUES(FLOOR(1 + (RAND() * 20)));<br />INSERT INTO book(card) VALUES(FLOOR(1 + (RAND() * 20)));<br />INSERT INTO book(card) VALUES(FLOOR(1 + (RAND() * 20)));<br />INSERT INTO book(card) VALUES(FLOOR(1 + (RAND() * 20)));<br />INSERT INTO book(card) VALUES(FLOOR(1 + (RAND() * 20)));<br />INSERT INTO book(card) VALUES(FLOOR(1 + (RAND() * 20)));<br />INSERT INTO book(card) VALUES(FLOOR(1 + (RAND() * 20)));<br />INSERT INTO book(card) VALUES(FLOOR(1 + (RAND() * 20)));<br />INSERT INTO book(card) VALUES(FLOOR(1 + (RAND() * 20)));<br />INSERT INTO book(card) VALUES(FLOOR(1 + (RAND() * 20)));<br />INSERT INTO book(card) VALUES(FLOOR(1 + (RAND() * 20)));<br />INSERT INTO book(card) VALUES(FLOOR(1 + (RAND() * 20)));<br />INSERT INTO book(card) VALUES(FLOOR(1 + (RAND() * 20)));
3.2 案例
- 下面开始explain分析
结论:type 有AllEXPLAIN SELECT * FROM class LEFT JOIN book ON class.card = book.card; - 添加索引优化 ```
ALTER TABLE book ADD INDEX Y ( card);
- 第2次explain
EXPLAIN SELECT * FROM class LEFT JOIN book ON class.card = book.card;
可以看到第二行的 type 变为了 ref,rows 也变成了优化比较明显。这是由左连接特性决定的。LEFT JOIN 条件用于确定如何从右表搜索行,左边一定都有,所以右边是我们的关键点,一定需要建立索引。
- 删除旧索引 + 新建 + 第3次explain
DROP INDEX Y ON book;
ALTER TABLE class ADD INDEX X (card);
EXPLAIN SELECT * FROM class LEFT JOIN book ON class.card = book.card;
#### 3.3 建议

- 保证被驱动表的join字段已经被索引
被驱动表 join 后的表为被驱动表 (需要被查询)
- left join 时,选择小表作为驱动表,大表作为被驱动表。
但是 left join 时一定是左边是驱动表,右边是被驱动表
- inner join 时,mysql会自己帮你把小结果集的表选为驱动表。
mysql 自动选择。小表作为驱动表。因为 驱动表无论如何都会被全表扫描。所以扫描次数越少越好
- 子查询尽量不要放在被驱动表,有可能使用不到索引。
select a.name ,bc.name from t_emp a left join
(select b.id , c.name from t_dept b inner join t_emp c on b.ceo = c.id)bc
on bc.id = a.deptid.
上段查询中用到了子查询,必然 bc 表没有索引。肯定会进行全表扫描
上段查询 可以直接使用 两个 left join 优化
select a.name , c.name from t_emp a
left outer join t_dept b on a.deptid = b.id
left outer join t_emp c on b.ceo=c.id
所有条件都可以使用到索引
若必须用到子查询,可将子查询设置为驱动表,,因为驱动表的type 肯定是 all,而子查询返回的结果表没有索引,必定也是all
### 4 子查询优化

> 用in还是exists

#### 4.1 实验

- 有索引 大表驱动小表
select sql_no_cache sum(sal) from emp where deptno in (select deptno from dept);
select sql_no_cache sum(sal) from emp where exists (select 1 from dept where emp.deptno=dept.deptno);
##用 exists 是否存在,存在返回一条记录,exists 是作为一个查询判断用,所以 select 后返回什么不重要。
select sql_no_cache sum(sal) from emp inner join dept on emp.deptno=dept.deptno;


- 有索引 小表驱动大表

有索引小表驱动大表 性能优于 大表驱动小表
- 无索引 小表驱动大表


- 无索引 大表驱动小表
select sql_no_cache sum(sal) from emp where deptno in (select deptno from dept);
select sql_no_cache sum(sal) from emp where exists (select 1 from dept where emp.deptno=dept.deptno);
select sql_no_cache sum(sal) from emp inner join dept on emp.deptno=dept.deptno;


#### 4.2 结论
- 有索引的情况下
- 用 inner join 是最好的 其次是 in ,exists最糟糕
- 无索引的情况下
- 小表驱动大表
因为join 方式需要distinct ,没有索引distinct消耗性能较大
所以 exists性能最佳,in其次,join性能最差
- 大表驱动小表
in 和 exists 的性能应该是接近的,都比较糟糕 ,exists稍微好一点但超不过5%
但是inner join 由于使用了 join buffer 所以快很多
### 5 order by关键字优化
#### 5.1 ORDER BY子句,尽量使用Index方式排序,避免使用FileSort方式排序
- 建表SQL
CREATE TABLE tblA(
id int primary key not null auto_increment,
age INT,
birth TIMESTAMP NOT NULL,
name varchar(200)
);
INSERT INTO tblA(age,birth,name) VALUES(22,NOW(),’abc’);
INSERT INTO tblA(age,birth,name) VALUES(23,NOW(),’bcd’);
INSERT INTO tblA(age,birth,name) VALUES(24,NOW(),’def’);
CREATE INDEX idx_A_ageBirth ON tblA(age,birth,name);
SELECT * FROM tblA;
- Case
- 1

- 2

- MySQL支持二种方式的排序,FileSort和Index
- Index效率高,它指MySQL扫描索引本身完成排序
- FileSort方式效率较低。
- ORDER BY满足两情况,会使用Index方式排序
- ORDER BY 语句使用索引最左前列
- 使用Where子句与Order BY子句条件列组合满足索引最左前列
- where子句中如果出现索引的范围查询(即explain中出现range)会导致order by 索引失效。
#### 5.2 尽可能在索引列上完成排序操作,遵照索引建的最佳左前缀

第二种中,`where a = const and b > const order by b , c `不会出现 using filesort, b , c 两个衔接上了
但是:`where a = const and b > const order by c` 将会出现 using filesort 。因为 b 用了范围索引,断了。而上一个 order by 后的b 用到了索引,所以能衔接上 c
#### 5.3 如果不在索引列上,filesort有两种算法:mysql就要启动双路排序和单路排序
#### 5.3.1 双路排序
- MySQL 4.1之前是使用双路排序,字面意思就是两次扫描磁盘,最终得到数据,
- 读取行指针和order by列,对他们进行排序,然后扫描已经排序好的列表,按照列表中的值重新从列表中读取对应的数据输出
- 取一批数据,要对磁盘进行了两次扫描,众所周知,I\O是很耗时的,所以在mysql4.1之后,出现了第二种改进的算法,就是单路排序。
#### 5.3.2 单路排序
- 从磁盘读取查询需要的所有列,按照order by列在buffer对它们进行排序,然后扫描排序后的列表进行输出,它的效率更快一些,避免了第二次读取数据。并且把随机IO变成了顺序IO,但是它会使用更多的空间,因为它把每一行都保存在内存中了。
#### 5.3.3 结论及引申出的问题
- 由于单路是后出的,总体而言好过双路
- 但是用单路有问题
在sort_buffer中,方法B比方法A要多占用很多空间,因为方法B是把所有字段都取出, 所以有可能取出的数据的总大小超出了sort_buffer的容量,导致每次只能取sort_buffer容量大小的数据,进行排序(创建tmp文件,多路合并),排完再取取sort_buffer容量大小,再排……从而多次I/O。
本来想省一次I/O操作,反而导致了大量的I/O操作,反而得不偿失。
#### 5.3.4 优化策略
- 增大sort_buffer_size参数的设置:用于单路排序的内存大小
- 增大max_length_for_sort_data参数的设置:单次排序字段大小。(单次排序请求)
- 去掉select 后面不需要的字段:select 后的多了,排序的时候也会带着一起,很占内存,所以去掉没有用的
- Why
提高Order By的速度:
1. Order by时select * 是一个大忌只Query需要的字段, 这点非常重要。在这里的影响是:
1.1 当Query的字段大小总和小于max_length_for_sort_data 而且排序字段不是 TEXT|BLOB 类型时,会用改进后的算法——单路排序, 否则用老算法——多路排序。
1.2 两种算法的数据都有可能超出sort_buffer的容量,超出之后,会创建tmp文件进行合并排序,导致多次I/O,但是用单路排序算法的风险会更大一些,所以要提高sort_buffer_size。
2. 尝试提高 sort_buffer_size
不管用哪种算法,提高这个参数都会提高效率,当然,要根据系统的能力去提高,因为这个参数是针对每个进程的
3. 尝试提高 max_length_for_sort_data
提高这个参数, 会增加用改进算法的概率。但是如果设的太高,数据总容量超出sort_buffer_size的概率就增大,明显症状是高的磁盘I/O活动和低的处理器使用率.
### 6 分页查询的优化---limit
EXPLAIN SELECT SQL_NO_CACHE * FROM emp ORDER BY deptno LIMIT 10000,40

那我们就给deptno这个字段加上索引吧。

然并卵。
优化:先利用覆盖索引把要取的数据行的主键取到,然后再用这个主键列与数据表做关联:(查询的数据量小了)
EXPLAIN SELECT SQL_NO_CACHE * FROM emp INNER JOIN (SELECT id FROM emp e ORDER BY deptno LIMIT 10000,40) a ON a.id=emp.id

最后比较一下查询速度:
优化前:


优化后:


实践证明: ① order by 后的字段(XXX)有索引 ② sql 中有 limit 时,
当 select id 或 XXX字段,索引包含字段时 ,显示 using index
当 select id 或 XXX字段,索引不包含的字段时,将显示 using filesort
### 7 GROUP BY关键字的优化
- group by实质是先排序后进行分组,遵照索引建的最佳左前缀
- 当无法使用索引列,增大max_length_for_sort_data参数的设置+增大sort_buffer_size参数的设置
- where高于having,能写在where限定的条件就不要去having限定了。
### 8 去重优化
尽量不要使用 distinct 关键字去重:优化
t_mall_sku 表
| id | shp_id | kcdz |
| ---- | ------ | ------------ |
| 3 | 1 | 北京市昌平区 |
| 4 | 1 | 北京市昌平区 |
| 5 | 5 | 北京市昌平区 |
| 6 | 3 | 重庆 |
| 8 | 8 | 天津 |
例子:
select kcdz form t_mall_sku where id in( 3,4,5,6,8 )
将产生重复数据
select distinct kcdz form t_mall_sku where id in( 3,4,5,6,8 )
使用 distinct 关键字去重,消耗性能

优化:
select kcdz form t_mall_sku where id in( 3,4,5,6,8 ) group by kcdz
能够利用到索引 ,group by kcdz 能够利用到索引

若有收获,就点个赞吧
0 人点赞


