- 一、概览
- 1.Collection
- 1. Set
- 2. List
- 3. Queue(队列)
- PriorityQueue源码分析(优先级对列)">1.PriorityQueue源码分析(优先级对列)
- ArrayBlockingQueue(以数组实现的阻塞队列)">2.ArrayBlockingQueue(以数组实现的阻塞队列)
- LinkedBlockingQueue(以单链表实现的阻塞队列)">3.LinkedBlockingQueue(以单链表实现的阻塞队列)
- SynchronousQueue(无缓冲阻塞队列)">4.SynchronousQueue(无缓冲阻塞队列)
- PriorityBlockingQueue(优先级阻塞队列)">5.PriorityBlockingQueue(优先级阻塞队列)
- LinkedTransferQueue源码分析">6.LinkedTransferQueue源码分析
- ConcurrentLinkedQueue">7.ConcurrentLinkedQueue
- DelayQueue源码分析(延时阻塞队列,常用于实现定时任务)">8.DelayQueue源码分析(延时阻塞队列,常用于实现定时任务)
- 4.Deque(双端队列)
- 2.Map
- 1.Collection
- 二、容器中的设计模式
一、概览
容器主要包括 Collection 和 Map 两种,Collection 存储着对象的集合,而 Map 存储着键值对(两个对象)的映射表。
1.Collection
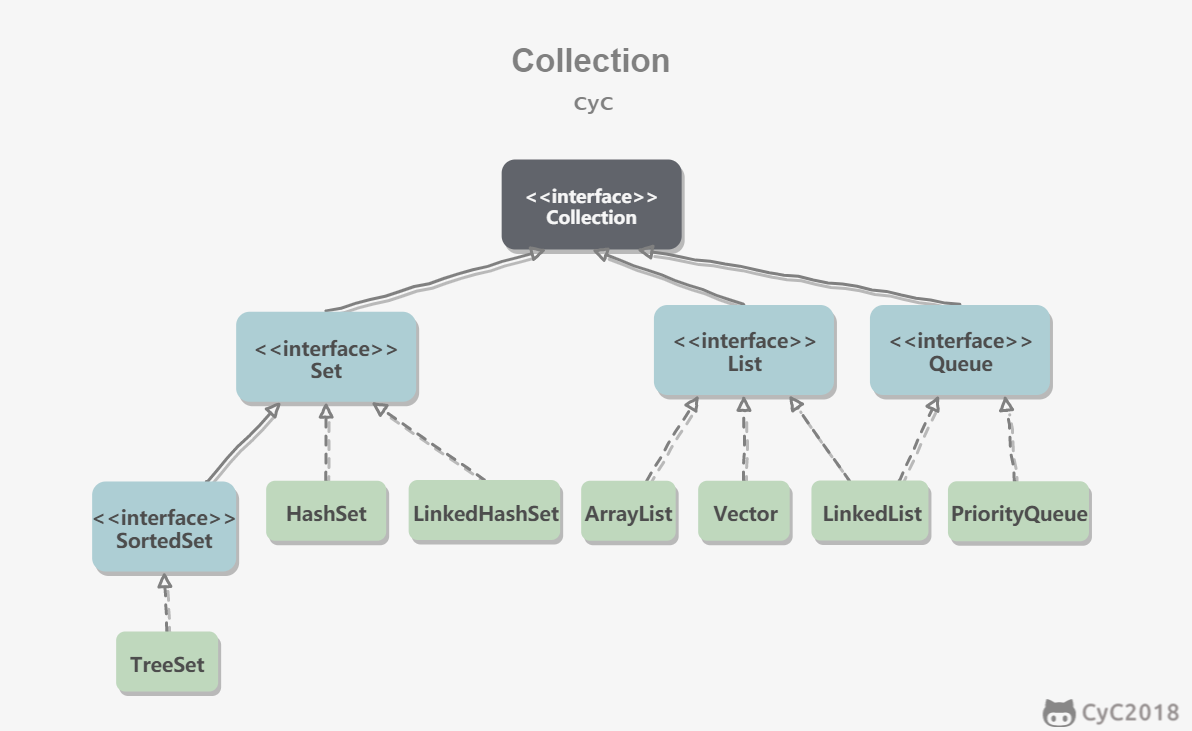
1. Set
1.TreeSet
基于红黑树实现,支持有序性操作(遍历结果确定),例如根据一个范围查找元素的操作。但是查找效率不如 HashSet,HashSet 查找的时间复杂度为 O(1),TreeSet 则为 O(logN)。
(1)TreeSet底层使用NavigableMap存储元素;(2)TreeSet是有序的;(3)TreeSet是非线程安全的;(4)TreeSet实现了NavigableSet接口,而NavigableSet继承自SortedSet接口;(5)TreeSet实现了SortedSet接口;
2.HashSet
基于哈希表实现,支持快速查找,但不支持有序性操作。并且失去了元素的插入顺序信息,也就是说使用 Iterator 遍历 HashSet 得到的结果是不确定的。
(1)HashSet内部使用HashMap的key存储元素,以此来保证元素不重复;(2)HashSet是无序的,因为HashMap的key是无序的;(3)HashSet中允许有一个null元素,因为HashMap允许key为null;(4)HashSet是非线程安全的;(5)HashSet是没有get()方法的;
3.LinkedHashSet
具有 HashSet 的查找效率,并且内部使用双向链表维护元素的插入顺序。
(1)LinkedHashSet继承自HashSet,它的添加、删除、查询等方法都是直接用的HashSet的,唯一的不同就是它使用LinkedHashMap存储元素。(2)LinkedHashSet是有序的,它是按照插入的顺序排序的。LinkedHashSet是不支持按访问顺序对元素排序的,只能按插入顺序排序。
4.CopyOnWriteArraySet
CopyOnWriteArraySet底层是使用CopyOnWriteArrayList存储元素的,所以它并不是使用Map来存储元素的。
(1)CopyOnWriteArraySet是用CopyOnWriteArrayList实现的;(2)CopyOnWriteArraySet是有序的,因为底层其实是数组,数组是不是有序的?!(3)CopyOnWriteArraySet是并发安全的,而且实现了读写分离;(4)CopyOnWriteArraySet通过调用CopyOnWriteArrayList的addIfAbsent()方法来保证元素不重复;
5.ConcurrentSkipListSet
(1)ConcurrentSkipListSet底层是使用ConcurrentSkipListMap实现的;(2)ConcurrentSkipListSet有序的,基于元素的自然排序或者通过比较器确定的顺序;(3)ConcurrentSkipListSet是线程安全的;
6.set大汇总
| Set | 有序性 | 线程安全 | 底层实现 | 关键接口 | 特点 |
|---|---|---|---|---|---|
| HashSet | 无 | 否 | HashMap | 无 | 简单 |
| LinkedHashSet | 有 | 否 | LinkedHashMap | 无 | 插入顺序 |
| TreeSet | 有 | 否 | NavigableMap | NavigableSet | 自然顺序 |
| CopyOnWriteArraySet | 有 | 是 | CopyOnWriteArrayList | 无 | 插入顺序,读写分离 |
| ConcurrentSkipListSet | 有 | 是 | ConcurrentNavigableMap | NavigableSet | 自然顺序 |
2. List
1.ArrayList
基于动态数组实现,支持随机访问。
(1)ArrayList内部使用数组存储元素,数组的默认大小为 10,当数组长度不够时进行扩容,每次加一半的空间,ArrayList不会进行缩容,扩容操作需要调用 Arrays.copyOf() 把原数组整个复制到新数组中。(2)ArrayList支持随机访问,通过索引访问元素极快,时间复杂度为O(1);(3)ArrayList添加元素到尾部极快,平均时间复杂度为O(1);(4)ArrayList添加元素到中间比较慢,因为要搬移元素,平均时间复杂度为O(n);(5)ArrayList从尾部删除元素极快,时间复杂度为O(1);(6)ArrayList从中间删除元素比较慢,因为要搬移元素,调用 System.arraycopy() 将 index+1 后面的元素都复制到 index 位置上,平均时间复杂度为O(n);(7)ArrayList支持求并集,调用addAll(Collection<? extends E> c)方法即可;(8)ArrayList支持求交集,调用retainAll(Collection<? extends E> c)方法即可;(9)ArrayList支持求单向差集,调用removeAll(Collection<? extends E> c)方法即可;(10)保存元素的数组 elementData 使用 transient 修饰,该关键字声明数组默认不会被序列化。ArrayList 实现了 writeObject() 和 readObject() 来控制只序列化数组中有元素填充那部分内容。(11)modCount 用来记录 ArrayList 结构发生变化的次数。结构发生变化是指添加或者删除至少一个元素的所有操作,或者是调整内部数组的大小,仅仅只是设置元素的值不算结构发生变化。在进行序列化或者迭代等操作时,需要比较操作前后 modCount 是否改变,如果改变了需要抛出 ConcurrentModificationException。
2.CopyOnWriteArrayList(ArrayList的线程安全版本)
CopyOnWriteArrayList是ArrayList的线程安全版本,内部也是通过数组实现,每次对数组的修改都完全拷贝一份新的数组来修改,修改完了再替换掉老数组,这样保证了只阻塞写操作,不阻塞读操作,实现读写分离。
(1)CopyOnWriteArrayList使用ReentrantLock重入锁加锁,保证线程安全;(2)CopyOnWriteArrayList的写操作都要先拷贝一份新数组,在新数组中做修改,修改完了再用新数组替换老数组,所以空间复杂度是O(n),性能比较低下;(3)CopyOnWriteArrayList的读操作支持随机访问,时间复杂度为O(1);(4)CopyOnWriteArrayList采用读写分离的思想,读操作不加锁,写操作加锁,且写操作占用较大内存空间,所以适用于读多写少的场合;(5)CopyOnWriteArrayList只保证最终一致性,不保证实时一致性;
3.Vector
和 ArrayList 类似,但它是线程安全的,默认情况下 Vector 每次扩容时容量都会翻倍。
4.LinkedList
(1)LinkedList是一个以双链表实现的List;(2)LinkedList还是一个双端队列,具有队列、双端队列、栈的特性;(3)LinkedList在队列首尾添加、删除元素非常高效,时间复杂度为O(1);(4)LinkedList在中间添加、删除元素比较低效,时间复杂度为O(n);(5)LinkedList不支持随机访问,所以访问非队列首尾的元素比较低效;(6)LinkedList在功能上等于ArrayList + ArrayDeque;
3. Queue(队列)
1.PriorityQueue源码分析(优先级对列)
1.优先级队列,是0个或多个元素的集合,集合中的每个元素都有一个权重值,每次出队都弹出优先级最大或最小的元素。一般来说,优先级队列使用堆来实现。(1)PriorityQueue是一个小顶堆;(2)PriorityQueue是非线程安全的;(3)PriorityQueue不是有序的,只有堆顶存储着最小的元素;(4)入队就是堆的插入元素的实现;(5)出队就是堆的删除元素的实现;(6)PriorityQueue是无限增长的队列
2.ArrayBlockingQueue(以数组实现的阻塞队列)
(1)ArrayBlockingQueue不需要扩容,因为是初始化时指定容量,并循环利用数组;(2)ArrayBlockingQueue利用takeIndex和putIndex循环利用数组;(3)入队和出队各定义了四组方法为满足不同的用途;(4)利用重入锁和两个条件保证并发安全;
3.LinkedBlockingQueue(以单链表实现的阻塞队列)
(1)LinkedBlockingQueue采用单链表的形式实现;(2)LinkedBlockingQueue采用两把锁的锁分离技术实现入队出队互不阻塞;(3)LinkedBlockingQueue是有界队列,不传入容量时默认为最大int值;
4.SynchronousQueue(无缓冲阻塞队列)
5.PriorityBlockingQueue(优先级阻塞队列)
6.LinkedTransferQueue源码分析
7.ConcurrentLinkedQueue
8.DelayQueue源码分析(延时阻塞队列,常用于实现定时任务)
(1)DelayQueue是阻塞队列;(2)DelayQueue内部存储结构使用优先级队列;(3)DelayQueue使用重入锁和条件来控制并发安全;(4)DelayQueue常用于定时任务;
4.Deque(双端队列)
ArrayDeque实现了Deque接口,Deque接口继承自Queue接口,它是对Queue的一种增强。
(1)ArrayDeque是采用数组方式实现的双端队列;(2)ArrayDeque的出队入队是通过头尾指针循环利用数组实现的;(3)ArrayDeque容量不足时是会扩容的,每次扩容容量增加一倍;(4)ArrayDeque可以直接作为栈使用;
2.Map
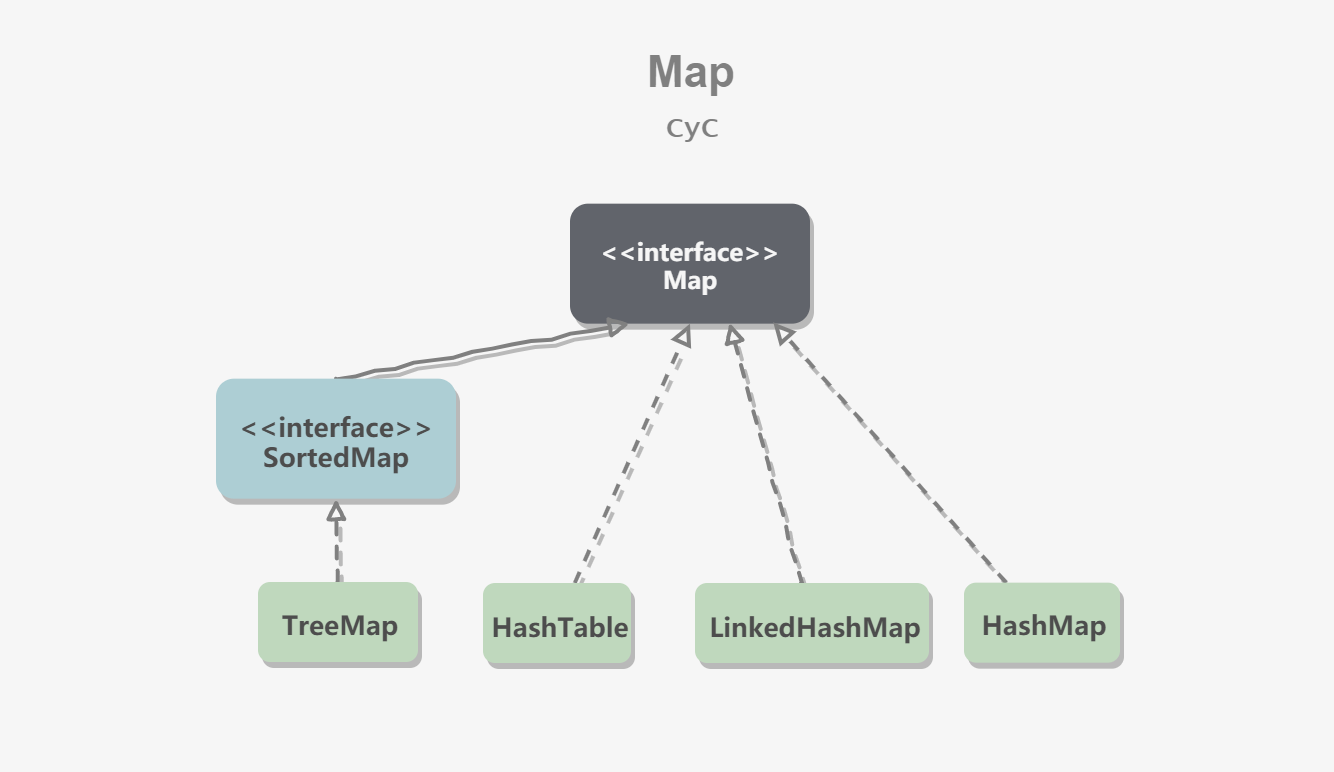
1.TreeMap
TreeMap使用红黑树存储元素,可以保证元素按key值的大小进行遍历。
红黑树特点:
(1)每个节点或者是黑色,或者是红色。(2)根节点是黑色。(3)每个叶子节点(NIL)是黑色。(注意:这里叶子节点,是指为空(NIL或NULL)的叶子节点!)(4)如果一个节点是红色的,则它的子节点必须是黑色的。(5)从一个节点到该节点的子孙节点的所有路径上包含相同数目的黑节点。(7)TreeMap的存储结构只有一颗红黑树;(8)TreeMap中的元素是有序的,按key的顺序排列;(9)TreeMap比HashMap要慢一些,因为HashMap前面还做了一层桶,寻找元素要快很多;(10)TreeMap没有扩容的概念;(11)TreeMap的遍历不是采用传统的递归式遍历;(12)TreeMap可以按范围查找元素,查找最近的元素;
红黑树插入平衡原则:根据不同的情况有以下几种处理方式:1.插入的元素如果是根节点,则直接涂成黑色即可,不用平衡;2.插入的元素的父节点如果为黑色,不需要平衡;3.插入的元素的父节点如果为红色,则违背了特性4,需要平衡,平衡时又分成下面三种情况:父节点为祖父节点的左节点:1.父节点为红色,叔叔节点也为红色,则将父节点和叔叔节点均变为黑色,祖父节点设置为红色,将祖父节点设置为新节点,进行下一次循环判断。2.父节点为红色,叔叔节点为黑色,且当前节点为父节点的右节点,则将父节点作为新的当前节点,进行左旋,进入情况33.父节点为红色,叔叔为黑色,且当前节点为父节点的左节点,则将父节点设为黑色,祖父节点设为红色,以祖父节点进行右旋。父节点为祖父节点的右节点:1.父节点为红色,叔叔节点也为红色,则将父节点和叔叔节点均变为黑色,祖父节点设置为红色,将祖父节点设置为新节点,进行下一次循环判断。2.父节点为红色,叔叔节点为黑色,且当前节点为父节点的左节点,则将父节点作为新的当前节点,进行右旋,进入情况33.父节点为红色,叔叔为黑色,且当前节点为父节点的右节点,则将父节点设为黑色,祖父节点设为红色,以祖父节点进行左旋。
treemap插入源码:http://cmsblogs.com/?p=4739
treemap删除源码:http://cmsblogs.com/?p=4741
2.HashMap
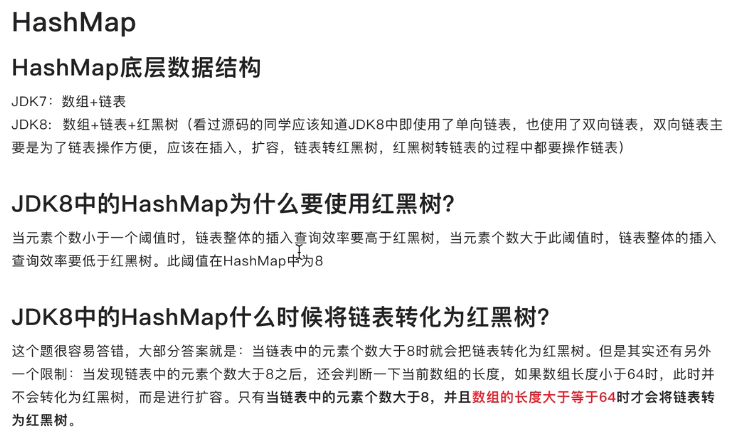
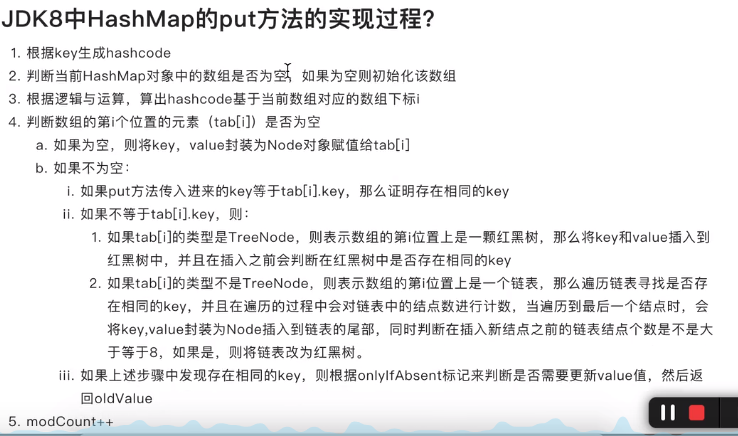
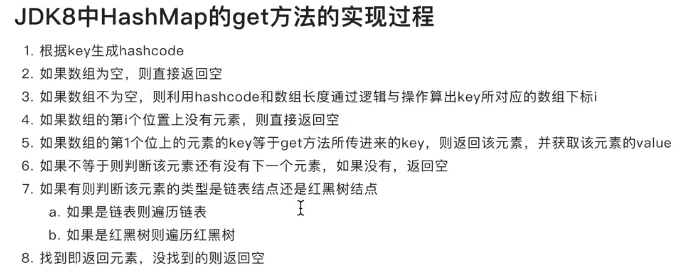
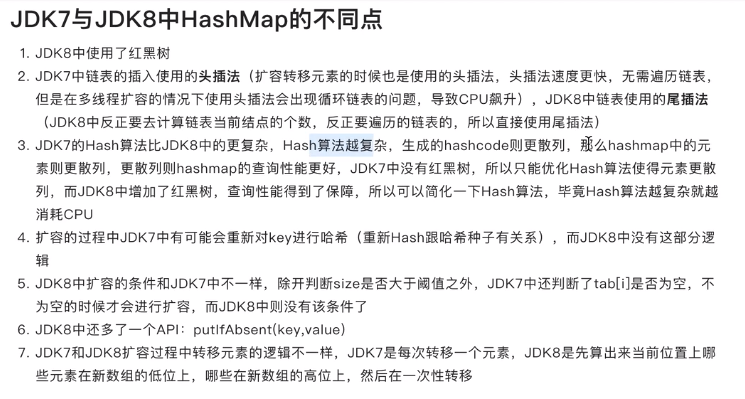
(1)HashMap是一种散列表,采用(数组 + 链表 + 红黑树)的存储结构;(2)HashMap的默认初始容量为16(1<<4),默认装载因子为0.75f,容量总是2的n次方;(3)HashMap扩容时每次容量变为原来的两倍;(4)当桶的数量小于64时不会进行树化,只会扩容;(5)当桶的数量大于64且单个桶中元素的数量大于8时,进行树化;(6)当单个桶中元素数量小于6时,进行反树化;(7)HashMap是非线程安全的容器;1.在JDK1.7中,当并发执行扩容操作时会造成环形链和数据丢失的情况。2.在JDK1.8中,在并发执行put操作时会发生数据覆盖的情况。(8)HashMap查找添加元素的时间复杂度都为O(1);(9) HashMap 允许插入键为 null 的键值对。但是因为无法调用 null 的 hashCode() 方法,也就无法确定该键值对的桶下标,只能通过强制指定一个桶下标来存放。HashMap 使用第 0 个桶存放键为 null 的键值对。
hashmap源码:http://cmsblogs.com/?p=4731
非线程安全:https://blog.csdn.net/small_love/article/details/112546761
3.HashTable
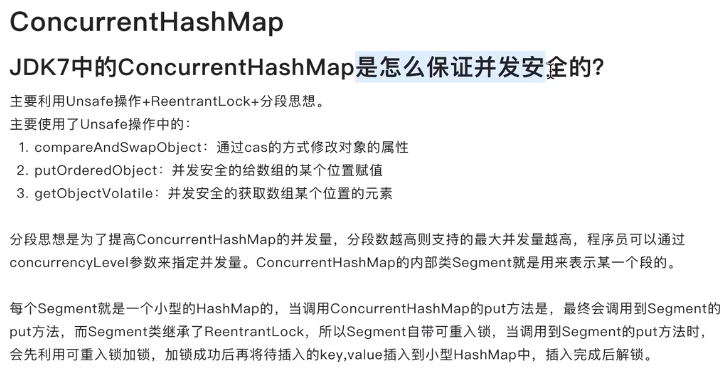
和 HashMap 类似,但它是线程安全的,这意味着同一时刻多个线程同时写入 HashTable 不会导致数据不一致。它是遗留类,不应该去使用它,而是使用 ConcurrentHashMap 来支持线程安全,ConcurrentHashMap 的效率会更高,因为 ConcurrentHashMap 引入了分段锁。
4.LinkedHashMap
LinkedHashMap内部维护了一个双向链表,能保证元素按插入的顺序访问,也能以访问顺序访问,可以用来实现LRU缓存策略。LinkedHashMap可以看成是 LinkedList + HashMap
(1)LinkedHashMap继承自HashMap,具有HashMap的所有特性;(2)LinkedHashMap内部维护了一个双向链表存储所有的元素;(3)如果accessOrder为false,则可以按插入元素的顺序遍历元素;(4)如果accessOrder为true,则可以按访问元素的顺序遍历元素;(5)LinkedHashMap的实现非常精妙,很多方法都是在HashMap中留的钩子(Hook),直接实现这些Hook就可以实现对应的功能了,并不需要再重写put()等方法;(6)默认的LinkedHashMap并不会移除旧元素,如果需要移除旧元素,则需要重写removeEldestEntry()方法设定移除策略;(7)LinkedHashMap可以用来实现LRU缓存淘汰策略;
LinkedHashMap源码分析:http://cmsblogs.com/?p=4733
5.WeakHashMap
(1)WeakHashMap使用(数组 + 链表)存储结构;(2)WeakHashMap中的key是弱引用,gc的时候会被清除;(3)每次对map的操作都会剔除失效key对应的Entry;(4)使用String作为key时,一定要使用new String()这样的方式声明key,才会失效,其它的基本类型的包装类型是一样的;(5)WeakHashMap常用来作为缓存使用;
6.ConcurrentHashMap
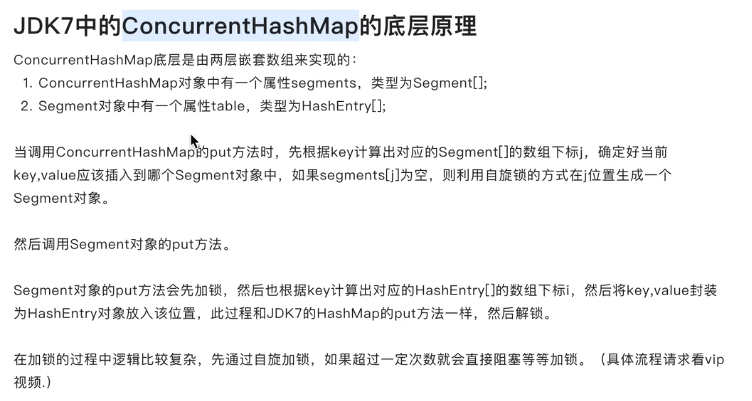
(1)ConcurrentHashMap是HashMap的线程安全版本;(2)ConcurrentHashMap采用(数组 + 链表 + 红黑树)的结构存储元素;(3)ConcurrentHashMap相比于同样线程安全的HashTable,效率要高很多;(4)ConcurrentHashMap采用的锁有 synchronized,CAS,自旋锁,分段锁,volatile等;(5)ConcurrentHashMap中没有threshold和loadFactor这两个字段,而是采用sizeCtl来控制;(6)sizeCtl = -1,表示一个线程正在进行初始化;(7)sizeCtl = 0,默认值,表示后续在真正初始化的时候使用默认容量;(8)sizeCtl > 0,在初始化之前存储的是传入的容量,在初始化或扩容后存储的是下一次的扩容门槛;(9)sizeCtl = (resizeStamp << 16) + (1 + nThreads),表示正在进行扩容,高位存储扩容邮戳,低位存储扩容线程数加1;(10)更新操作时如果正在进行扩容,当前线程协助扩容;(11)更新操作会采用synchronized锁住当前桶的第一个元素,这是分段锁的思想;(12)整个扩容过程都是通过CAS控制sizeCtl这个字段来进行的,这很关键;(13)迁移完元素的桶会放置一个ForwardingNode节点,以标识该桶迁移完毕;(14)元素个数的存储也是采用的分段思想,类似于LongAdder的实现;(15)元素个数的更新会把不同的线程hash到不同的段上,减少资源争用;(16)元素个数的更新如果还是出现多个线程同时更新一个段,则会扩容段(CounterCell);(17)获取元素个数是把所有的段(包括baseCount和CounterCell)相加起来得到的;(18)查询操作是不会加锁的,所以ConcurrentHashMap不是强一致性的;(19)ConcurrentHashMap中不能存储key或value为null的元素;
7.ConcurrentSkipListMap(跳表)
(1)跳表是可以实现二分查找的有序链表;(2)每个元素插入时随机生成它的level;(3)最低层包含所有的元素;(4)如果一个元素出现在level(x),那么它肯定出现在x以下的level中;(5)每个索引节点包含两个指针,一个向下,一个向右;(6)跳表查询、插入、删除的时间复杂度为O(log n),与平衡二叉树接近;
8.map中常见问题

二、容器中的设计模式
迭代器模式
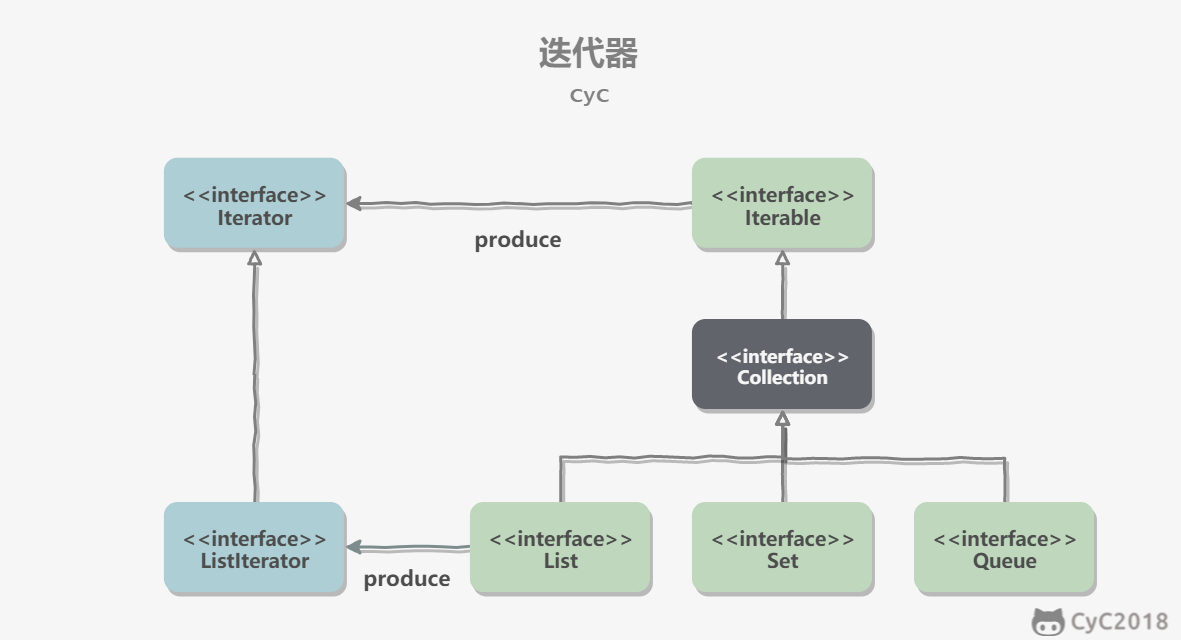
Collection 继承了 Iterable 接口,其中的 iterator() 方法能够产生一个 Iterator 对象,通过这个对象就可以迭代遍历 Collection 中的元素。
//从 JDK 1.5 之后可以使用 foreach 方法来遍历实现了 Iterable 接口的聚合对象。List<String> list = new ArrayList<>();list.add("a");list.add("b");for (String item : list) {System.out.println(item);}
适配器模式
java.util.Arrays#asList() 可以把数组类型转换为 List 类型。
@SafeVarargspublic static <T> List<T> asList(T... a)
应该注意的是 asList() 的参数为泛型的变长参数,不能使用基本类型数组作为参数,只能使用相应的包装类型数组。
Integer[] arr = {1, 2, 3};List list = Arrays.asList(arr);//也可以使用以下方式调用 asList():List list = Arrays.asList(1, 2, 3);

若有收获,就点个赞吧
0 人点赞


