什么是 MongoDB
MongoDB 是一个文档数据库,提供好的性能,领先的非关系型数据库。采用 BSON 存储文档数据。2007年10月,MongoDB由10gen团队所发展。2009年2月首度推出。MongoDB 用 c++ 编写的。
优势:
- 面向文档的存储:以 JSON 格式的文档保存数据。
- 任何属性都可以建立索引。
- 复制以及高可扩展性。
- 自动分片。
- 丰富的查询功能。
- 快速的即时更新。
- 来自 MongoDB 的专业支持。
Elasticsearch 与 MongoDB 相同点与不同点
相同点
- 都是以 JSON 格式管理数据的 nosql 数据库。
- 都支持 CRUD 操作。
- 都支持聚合和全文检索。
- 都支持分片和复制。
- 都支持阉割版的 join 操作。
- 都支持处理超大规模数据。
不同点
- ES 是 Java 编写,通过 RESTFul 接口操作数据。MongoDB 是 C++ 编写,通过 driver 操作数据。(ES 对 java 开发更有好,利于排查理解)
- MongoDB 的分片有 hash 和 range 两种方式,ES 只有 hash 一种。
- ES 是天生分布式,主副分片自动分配和复制,开箱即用。MongoDB 的分布式是由“前置查询路由+配置服务+shard集合”,需要手动配置集群服务。
- 内部存储 ES 是到排索引 + docvalues + fielddata。MongoDB 暂时未知。
- ES 全文检索有强大的分析器且可以灵活组合,查询时智能匹配。MongoDB 的全文检索字段个数有限制。
- ES 所有字段自动索引,MongoDB 的字段需要手动索引。
- MongoDB 4.2 以后支持多文档事务(ACID)
总结
ES 偏向于检索、查询、数据分析,适用于 OLAP 系统。MongoDB 偏向于大数据规模下的 CRUD,适用于对事务要求不强的 OLTP 系统。
MongoDB 的 CURD
执行 mongo 命令连接 MongoDB
数据库的操作
MongoDB自带的原始数据库:
admin:从权限角度来看,这是“root”数据库。如果将一个用户添加到这个数据库。这个用户自动继承所有数据库的权限。一些特定的服务器端命令也只能从这个数据库运行,比如列出所有的数据库或者关闭服务器
local:这个数据永远不会被复制,可以用来存储限于本地单台服务器的任意集合
config:当 mongo 用于分片设置时,config 数据库在内部使用。用于保存分片的相关信息
**
查看
show dbs
创建
使用 use 时,如果数据库存在则会进入到相应的数据库,如果不存在则会自动创建,一旦进入数据库,则可以使用db来引用当前库;如果是第一次创建,那个这个数据库只是存在于内存当中,直到这个数据库中创建了集合后才会持久化到磁盘上
use 数据库名
删除
用于删除已经持久化的数据库,刚创建在内存中的数据库删除无效
db.dropDatabase()
集合的操作
创建
db.createCollection("集合名称")
查看
show tables
show collections
删除
db.集合名称.drop()
文档的操作
测试数据
db.xyj.insertMany([
    {name:"沙和尚", age:38, gender:"男", hobby:["打篮球","吃喝"]},
    {name:"白骨精", age:16, gender:"女", hobby:["吃喝"]},
    {name:"蜘蛛精", age:14, gender:"女", hobby:["跑步","打乒乓球"]},
        {name:"唐生", age:25, gender:"男", hobby:["坐禅","吃喝"]}
]);
查看
查看所有
db.xyj.find()
投影查询
1 表示显示,0 表示强制隐藏**
db.xyj.find({name:"猪八戒"}, {name: 1, _id: 0})
按字段条件查询
db.xyj.find({name:"猪八戒"})
按字段条件查询并只返回一条
db.xyj.findOne({name:"猪八戒"})
组合查询
格式:db.xyj.find($and: [{}, {}, {}])

// 查询年级大于20小于50的
db.xyj.find({$and:[{age:{$gt:NumberInt(20)}}, {age:{$lt:NumberInt(50)}}]})

// 查询名字里有“精”的或者年纪大于30的
db.xyj.find({$or:[{age:{$gt:NumberInt(30)}},{name:/精/}]})
比较查询
**
$gt -> 大于;$lt -> 小于;$gte ->大于等于;$lte -> 小于等于;$ne -> 不等于
// 查询年级大于20岁的
db.xyj.find({age:{$gt:NumberInt(20)}})
包含查询
db.xyj.find({age:{$in:[28, 38]}}) // 包含
db.xyj.find({age:{$nin:[28, 38]}}) // 不包含
模糊查询(正则匹配)
db.xyj.find({"name": /精/}) // like
统计查询
db.xyj.count()
db.xyj.count({字段: 条件})
取模
比如我们要匹配 age % 5 == 1
db.xyj.find({"age": {$mod: [5, 1]}})
是否存在
db.xyj.find({"love": {"$exists": true}})  // 如果存在字段 love,就返回
db.xyj.find({"love": {"$exists": false}}) // 如果不存在字段 love,就返回
添加
单个添加
**
xyj 是集合名称,如果该集合还没有被创建,则会自动创建
db.xyj.insert({name:"猪八戒", age:28, gender:"男"});
db.xyj.insertOne({_id:"workd", name:"猪八戒", age:28, gender:"男"});
批量添加
**
当我们向集合中插入文档时,如果没有给文档指定 _id 属性,则数据库会自动为文档添加 _id 该属性用来作为文档的唯一标识 _id 我们可以自己指定,如果我们指定了数据库就不会在添加了,如果自己指定 _id 也必须确保它的唯一性
db.xyj.insert([
     {name:"沙和尚", age:38, gender:"男"},
     {name:"白骨精", age:16, gender:"女"},
     {name:"蜘蛛精", age:14, gender:"女"}
]);

db.xyj.insertMany([
     {name:"沙和尚", age:38, gender:"男"},
     {name:"白骨精", age:16, gender:"女"},
     {name:"蜘蛛精", age:14, gender:"女"}
]);
额外小知识
**
try {
    db.xyj.insert([
      {name:"沙和尚",age:38,gender:"男"},
      {name:"白骨精",age:16,gender:"女"},
      {name:"蜘蛛精",age:14,gender:"女"}
    ]);
} catch(e) {
    print(e)
}

可以知道那条插入失败
修改
覆盖修改
**
执行效果:_id: hello 这条数据只有 age 一个字段了
db.xyj.update(
        {_id: "hello"},
    {age: NumberInt(30)}
)
局部修改
**
执行效果:只会修改这条数据的某个字段
db.xyj.update(
        {_id: "workd"},
    {$set: {age: NumberInt(30)}}
)
批量修改
**
在修改多条数据时,必须要加上第三个参数,否则只会修改一条数据
db.xyj.update(
        {name: "蜘蛛精"},
    {$set: {age:NumberInt(100)}},
    {multi:true}
)
字段增加操作
注意:$inc **对应的字段必须是数字,而且递增或递减的值也必须是数字。
db.xyj.update(
        {_id: "workd"},
    {$inc: {age:NumberInt(1)}}
)
删除
**
删除文档
db.xyj.remove({_id: "workd"})
删除文档字段
$unset** 指定字段的值只需是任意合法值即可。
db.xyj.update(
        {"_id": 123},
    {"$unset": {"name": 1}}
)
删除所有
db.xyj.remove({})
数组
添加($push)
db.xyj.update(
        {"name": "白骨精"},
    {"$push": {"hobby": "念佛"}}
)
删除(按位置删除)($pop)
// 删除最后一个元素
db.xyj.update(
        {"_id": ObjectId("5e80950a2b2f5820a1958a43")},
    {"$pop": {"hobby": 1}}
)

// 删除第一个元素
db.xyj.update(
        {"_id": ObjectId("5e80950a2b2f5820a1958a43")},
    {"$pop": {"hobby": -1}}
)
删除(指定元素)($pull)
db.xyj.update(
        {"_id": ObjectId("5e80950a2b2f5820a1958a44")},
    {"$pull": {"hobby": "跑步"}}
)
更新嵌套数组的值
// 插入测试数据
db.xyj.insert(
        {name:"猪八戒", age:28, gender:"男",
    address: [
            {place: "nanji", tel: 123},
            {place: "dongbei", tel: 321}
    ]}
);
// 更新
db.xyj.update(
        {"_id": ObjectId("5e809fc665a1965fdc792fc8")},
    {"$set": {"address.0.tel": 213}}
)
数组查询
// 单条件匹配查询
db.xyj.find({"hobby":"跑步"})

// 多条件匹配查询
// 只有 hobby 数组同时存在跑步和打乒乓球才会匹配
db.xyj.find({"hobby":{"$all": ["跑步", "打乒乓球"]}})

// 根据数组长度查询
// 只有数组的长度是2才会匹配
db.xyj.find({"hobby": {"$size": 2}})
分页查询
limit:显示几条记录,skip:跳过几条记录,sort:排序
执行顺序: sort > skip > limit
db.xyj.find().limit(2)
db.xyj.find().limit(2).skip(2)
db.xyj.find().limit(2).skip(2).sort({age:1})   // 1 代表升序,-1 代表降序
聚合管道
较常见的管道操作符以及他们的作用:
| 操作符 | 描述 | 语法 |
|---|---|---|
| $project | 数据投影,主要用于重命名,增加,删除字段 | db.article.aggregate({ $project : {title : 1 ,author : 1 ,}}); |
| $match | 过滤,筛选符合条件的文档,作为下一阶段输入 | db.articles.aggregate( [{ $match : { score : { $gt : 70, $lte : 90 } } },{ $group: { _id: null, count: { $sum: 1 } } }] ); |
| $limit | 限制经过管道的文档数量 | db.article.aggregate({ $limit : 5 }); |
| $skip | 待操作集合处理前跳过部分文档 | db.article.aggregate({ $skip : 5 }); |
| $unwind | 将数组拆分成独立的行 | db.article.aggregate({$project:{author:1,title:1,tags:1}},{$unwind:"$tags"}) |
| $group | 对数据进行分组 | db.article.aggregate({ $group : {_id : "$author",docsPerAuthor : { $sum : 1 },viewsPerAuthor : { $sum : "$pageViews" }}}); |
| $sort | 对文档按照指定字段排序 | db.users.aggregate( { $sort : { age : -1, posts: 1 } }); |
| $sample | 随机选择从其输入指定数量的文档。 | { $sample: { size: <positive integer> } } |
| $out | 必须为pipeline最后一个阶段管道,因为是将最后计算结果写入到指定的collection中 | |
| $indexStats | 返回数据集合的每个索引的使用情况 | { $indexStats: { } } |
测试数据
document1=({name:'dogOne',age:1,tags:['animal','dog'],type:'dog',money:[{min:100},{norm:200},{big:300}]});
document2=({name:'catOne',age:3,tags:['animal','cat'],type:'cat',money:[{min:50},{norm:100},{big:200}]});
document3=({name:'catTwo',age:2,tags:['animal','cat'],type:'cat',money:[{min:20},{norm:50},{big:100}]});
document4=({name:'dogTwo',age:5,tags:['animal','dog'],type:'dog',money:[{min:300},{norm:500},{big:700}]});
document5=({name:'appleOne',age:0,tags:['fruit','apple'],type:'apple',money:[{min:10},{norm:12},{big:13}]});
document6=({name:'appleTwo',age:0,tags:['fruit','apple'],type:'apple',money:[{min:10},{norm:12},{big:13}]});
document7=({name:'pineapple',age:0,tags:['fruit','pineapple'],type:'pineapple',money:[{min:8},{norm:9},{big:10}]});

db.mycol.insert(document1)
db.mycol.insert(document2)
db.mycol.insert(document3)
db.mycol.insert(document4)
db.mycol.insert(document5)
db.mycol.insert(document6)
db.mycol.insert(document7)
假定我们想提取 money 中 min 为 100 的文档,并且只输出 name 和 money 数组中的 min 那一项
db.mycol.aggregate(
 {$match:{'money.min':100}},
 {$project:{_id:0,name:'$name',minprice:'$money.min'}}
)
假定我们想提取 money 中 min 小于100的文档,并且限制 3 个文档,跳过一个文档再显示
db.mycol.aggregate(
  {$match:{'money.min':{$lt:100}}},
  {$limit:3},
  {$skip:1},
  {$project:{_id:0,name:'$name',minprice:'$money.min'}}
)
通过 type 类型来对数据进行分类,并且同时统计他们的年龄 age 总和
db.mycol.aggregate(
  {$group:{_id:'$type',sumage:{$sum:'$age'}}}
)
按照年龄对数据进行排序
db.mycol.aggregate(
  {$group:{_id:'$type',sumage:{$sum:'$age'}}},
  {$sort:{sumage:1}}
)
文档模式设计的基本策略

其实很简单,我们一般建议的是先考虑内嵌, 直接按照你的对象模型来设计你的数据模型。如果你的对象模型数量不多,关系不是很复杂,那么恭喜你,可能直接一种对象对应一个集合就可以了。
内嵌是文档模型的特色,可以充分利用MongoDB的富文档功能来享受我们刚才谈到的一些文档模型的性能和扩展性等特性。一般的一对一、一对多关系,比如说一个人多个地址多个电话等等都可以放在一个文档里用内嵌来完成。
但是有一些时候,使用引用则难以避免。比如说, 一个明星的博客可能有几十万或者几百万的回复,这个时候如果把comments放到一个数组里,可能会超出16M的限制。这个时候你可以考虑使用引用的方式,在主表里存储一个id值,指向另一个表中的 id 值。使用引用要注意的就是:从性能上讲,一般我们可能需要两次以上才能把需要的数据取回来。更加重要的是:需要把数据存放到两个集合里,但是目前为止MongoDB并不支持跨表的事务性,所以对于强事务的应用场景要谨慎使用。
设计原则
**
为应用程序提供服务,而不是为了存储优化
为实现最佳性能而设计
购物车场景设计
db.cart.insert({
  "userid": 1000,
  "last_activity": new Date(),
  "status": "active",
  "items": [
    {
    "itemid": 1000,
    "title": "mianbao",
    "price": 5.00,
    "quantity": 1,
    "img_url":["mianbao.jpg"]
    }
  ]
});
在这里我们把商品的一些主要信息放到购物车里了,比如说 title,price,quantity,为什么? 读一次所有信息都拿到了:价格、数量等等,不需要再去查另一张表。这是一种比较常见的优化手段,用冗余的方式来提供读取性能。
向购物车添加数据
比如说,如果我们想要往购物车里增加一个价值 2 元的面包,我们可以用下面的 update 语句。注意 $push 的用法。$push 类似于 javascript 的操作符,意思是往数组尾部增加一个元素。
db.cart.update(
    {
        "_id": ObjectId("5ea6e2749d7d0000c00043aa")
    },
    {
        "$push":
        {
            "items":
            {
                "itemid": 1001,
                "title": "niupai",
                "price": 2.00,
                "quantity": 1,
                "img_url": "bread.jpg"
            }
        },
        $set: {
            "last_activity": new Date()
        }
    }
);
更新数量
db.cart.update(
    {
        "_id": ObjectId("5e833a5acaea32e75f6f5b5e"),
        "items.itemid": 1001
    },
    {
        $set: {
            "items.$.quantity": 5,
            "last_activity": new Date()
        }
    }
)
统计所有商品的总价
$sum:1:如果前面的情况出现一次,后满的就加 1,如果后面 $sum:2 那么每次前面条件满足一次就加 2
使用了$group:_id :强制必须存在。可以为 null。_id:null,表示则意为对所有行进行分组统计
db.cart.aggregate(
    [
        {
            "$match": {
                "_id": ObjectId("5e96aa9f3bbe036e72bbc946")
            }
        },
        {
            "$unwind": "$items"
        },
        {
            $group: {
                _id: null,
                totalPrice: {
                    $sum: {
                        $multiply: ["$items.price", "$items.quantity"]
                    }
                },
                count: {
                    $sum: 1
                }
            }
        }
    ]
)
统计单个商品的总价
db.cart.aggregate(
    [
        {
            "$match": {
                "_id": ObjectId("5e833a5acaea32e75f6f5b5e")
            }
        },
        {
            "$unwind": "$items"
        },
        {
            $project:
            {
                total_price: {
                    $multiply: ["$items.price", "$items.quantity"]
                }
            }
        }
    ]
)
社交网络案例
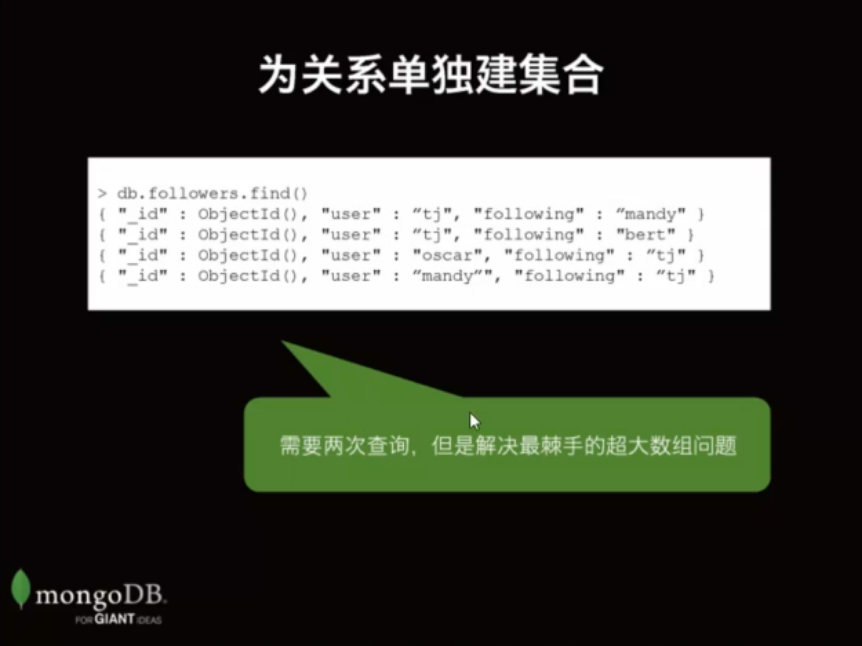
对于关系描述,使用文档模型的内嵌数组特性,我们可以很容易地把我关注的用户(following)和关注我的用户表示出来。下例表示 TJ 我的关注的用户是 mandy 和 bert,而 oscar 和 mandy 则在关注我。这种模式是文档模型中最经典的。但是有一个潜在问题就是如果 TJ 我是一个明星,他们关注我的人可能有千万。一个千万级的数组会有两个问题:1) 有可能超出一个文档最大16M的硬性限制; 2) MongoDB数组太大会严重影响性能。

怎么办?我们可以建立一个专门的集合来描述关注关系。这里就是一个内嵌和引用的经典选择。我们希望用内嵌,但是如果数组维度太大,就需要考虑用另外一个集合的方式来表示一对多的关系(用户 1–N 关注者)

若有收获,就点个赞吧
0 人点赞


