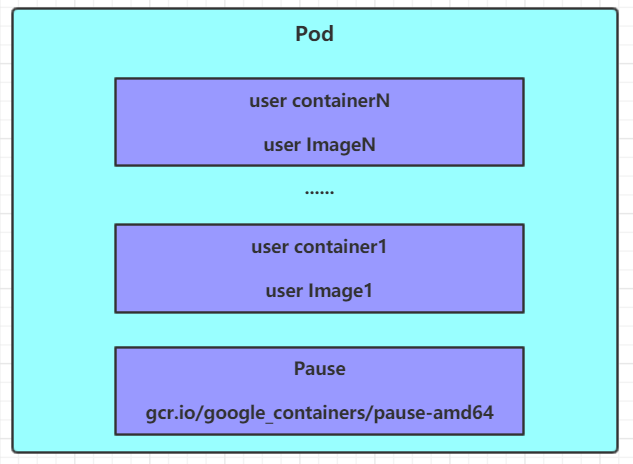
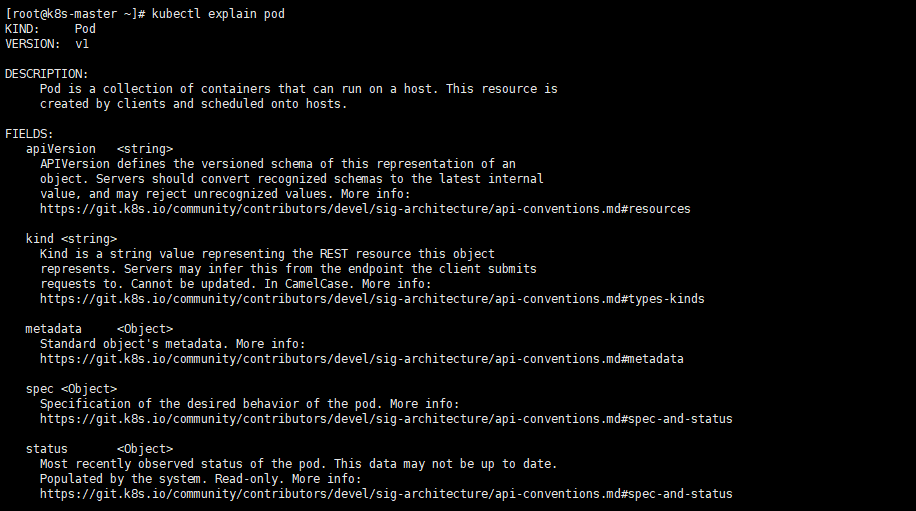
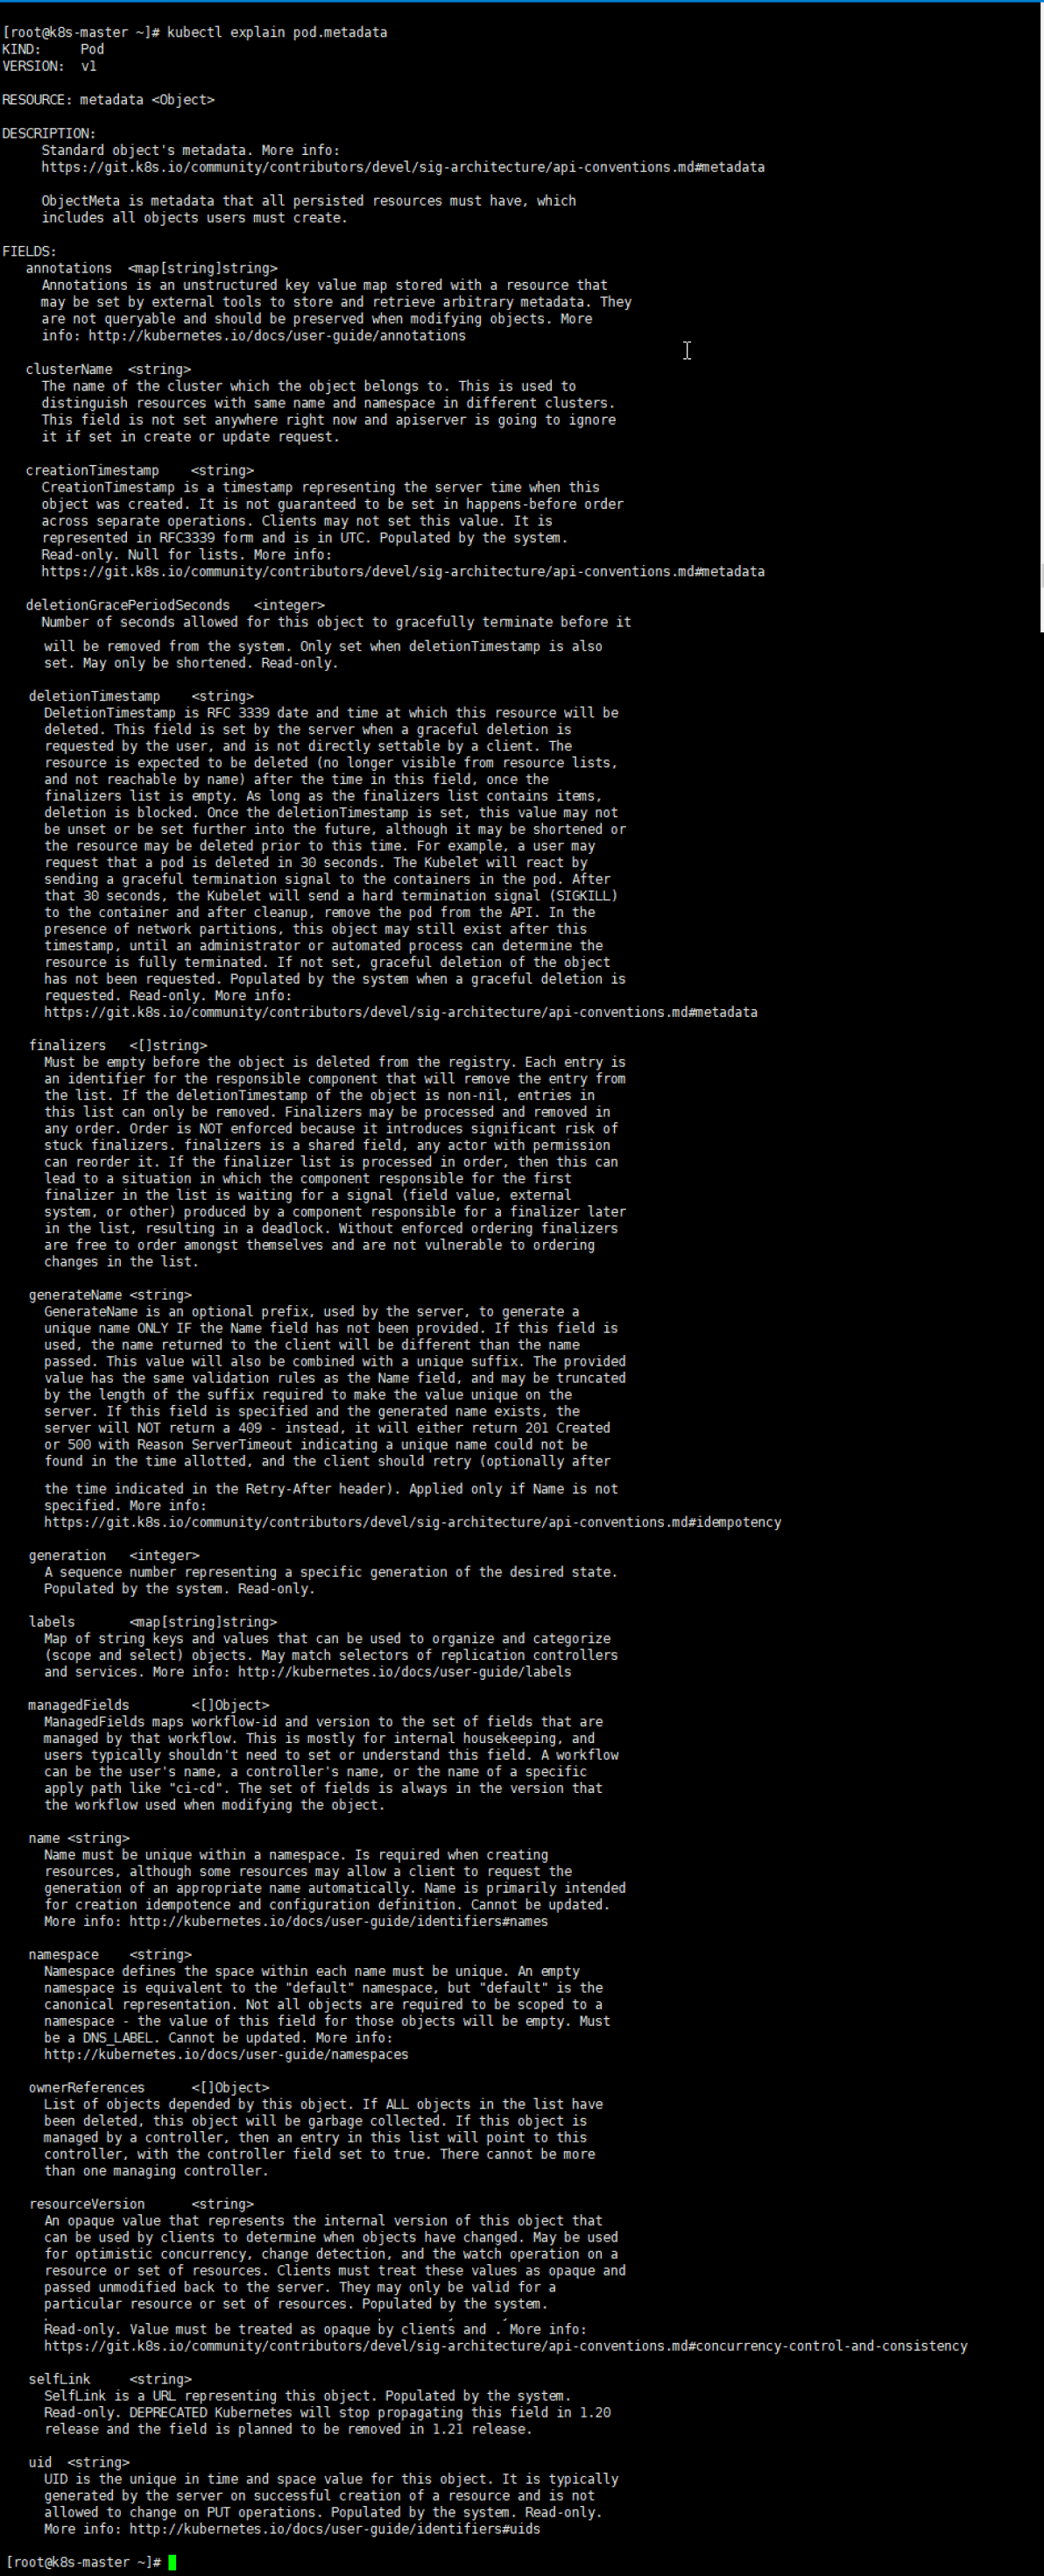
1 Pod的介绍1.1 Pod的结构1.2 Pod定义2 Pod的配置2.1 概述2.2 基本配置2.3 镜像拉取策略2.4 启动命令2.5 环境变量(不推荐)2.6 端口设置2.7 资源配额3 Pod的生命周期3.1 概述3.2 创建和终止3.2.1 Pod的创建过程3.2.2 Pod的终止过程3.3 初始化容器3.4 钩子函数3.5 容器探测3.5.1 概述3.5.2 exec方式3.5.3 tcpSocket方式3.5.4 httpGet方式3.5.5 容器探测的补充3.6 重启策略4 Pod的调度4.1 概述4.2 定向调度4.2.1 概述4.2.2 nodeName4.2.3 nodeSelector4.3 亲和性调度4.3.1 概述4.3.2 nodeAffinity4.3.3 podAffinity4.3.4 podAntiAffinity4.4 污点和容忍4.4.1 污点(Taints)4.4.2 容忍(Toleration)5 临时容器5.1 概述5.2 什么是临时容器?5.3 临时容器的用途5.4 临时容器的配置5.5 使用临时容器在线debug6 服务质量Qos6.1 概述6.2 Qos之Guaranteed6.2.1 概述6.2.2 应用示例6.3 Qos之Burstable6.3.1 概述6.3.2 应用示例6.4 Qos之BestEffort6.4.1 概述6.4.2 应用示例6.5 Qos的应用 详细介绍Pod资源的各种配置(YAML)和原理。 1 Pod的介绍 1.1 Pod的结构 每个Pod中都包含一个或者多个容器,这些容器可以分为两类:① 用户程序所在的容器,数量可多可少。② Pause容器,这是每个Pod都会有的一个根容器,它的作用有两个: 可以以它为依据,评估整个Pod的健康状况。可以在根容器上设置IP地址,其它容器都共享此IP(Pod的IP),以实现Pod内部的网络通信(这里是Pod内部的通讯,Pod之间的通讯采用虚拟二层网络技术来实现,我们当前环境使用的是Flannel)。 1.2 Pod定义 下面是Pod的资源清单: apiVersion: v1 #必选,版本号,例如v1kind: Pod #必选,资源类型,例如 Podmetadata: #必选,元数据 name: string #必选,Pod名称 namespace: string #Pod所属的命名空间,默认为"default" labels: #自定义标签列表 - name: string spec: #必选,Pod中容器的详细定义 containers: #必选,Pod中容器列表 - name: string #必选,容器名称 image: string #必选,容器的镜像名称 imagePullPolicy: [ Always|Never|IfNotPresent ] #获取镜像的策略 command: [string] #容器的启动命令列表,如不指定,使用打包时使用的启动命令 args: [string] #容器的启动命令参数列表 workingDir: string #容器的工作目录 volumeMounts: #挂载到容器内部的存储卷配置 - name: string #引用pod定义的共享存储卷的名称,需用volumes[]部分定义的的卷名 mountPath: string #存储卷在容器内mount的绝对路径,应少于512字符 readOnly: boolean #是否为只读模式 ports: #需要暴露的端口库号列表 - name: string #端口的名称 containerPort: int #容器需要监听的端口号 hostPort: int #容器所在主机需要监听的端口号,默认与Container相同 protocol: string #端口协议,支持TCP和UDP,默认TCP env: #容器运行前需设置的环境变量列表 - name: string #环境变量名称 value: string #环境变量的值 resources: #资源限制和请求的设置 limits: #资源限制的设置 cpu: string #Cpu的限制,单位为core数,将用于docker run --cpu-shares参数 memory: string #内存限制,单位可以为Mib/Gib,将用于docker run --memory参数 requests: #资源请求的设置 cpu: string #Cpu请求,容器启动的初始可用数量 memory: string #内存请求,容器启动的初始可用数量 lifecycle: #生命周期钩子 postStart: #容器启动后立即执行此钩子,如果执行失败,会根据重启策略进行重启 preStop: #容器终止前执行此钩子,无论结果如何,容器都会终止 livenessProbe: #对Pod内各容器健康检查的设置,当探测无响应几次后将自动重启该容器 exec: #对Pod容器内检查方式设置为exec方式 command: [string] #exec方式需要制定的命令或脚本 httpGet: #对Pod内个容器健康检查方法设置为HttpGet,需要制定Path、port path: string port: number host: string scheme: string HttpHeaders: - name: string value: string tcpSocket: #对Pod内个容器健康检查方式设置为tcpSocket方式 port: number initialDelaySeconds: 0 #容器启动完成后首次探测的时间,单位为秒 timeoutSeconds: 0 #对容器健康检查探测等待响应的超时时间,单位秒,默认1秒 periodSeconds: 0 #对容器监控检查的定期探测时间设置,单位秒,默认10秒一次 successThreshold: 0 failureThreshold: 0 securityContext: privileged: false restartPolicy: [Always | Never | OnFailure] #Pod的重启策略 nodeName: <string> #设置NodeName表示将该Pod调度到指定到名称的node节点上 nodeSelector: obeject #设置NodeSelector表示将该Pod调度到包含这个label的node上 imagePullSecrets: #Pull镜像时使用的secret名称,以key:secretkey格式指定 - name: string hostNetwork: false #是否使用主机网络模式,默认为false,如果设置为true,表示使用宿主机网络 volumes: #在该pod上定义共享存储卷列表 - name: string #共享存储卷名称 (volumes类型有很多种) emptyDir: {} #类型为emtyDir的存储卷,与Pod同生命周期的一个临时目录。为空值 hostPath: string #类型为hostPath的存储卷,表示挂载Pod所在宿主机的目录 path: string #Pod所在宿主机的目录,将被用于同期中mount的目录 secret: #类型为secret的存储卷,挂载集群与定义的secret对象到容器内部 scretname: string items: - key: string path: string configMap: #类型为configMap的存储卷,挂载预定义的configMap对象到容器内部 name: string items: - key: string path: string 语法:查看每种资源的可配置项 # 查看某种资源可以配置的一级配置kubectl explain 资源类型 # 查看属性的子属性kubectl explain 资源类型.属性 示例:查看资源类型为pod的可配置项 kubectl explain pod 示例:查看资源类型为Pod的metadata的属性的可配置项 kubectl explain pod.metadata 在kubernetes中基本所有资源的一级属性都是一样的,主要包含5个部分: apiVersion :版本,有kubernetes内部定义,版本号必须用kubectl api-versions查询。kind :类型,有kubernetes内部定义,类型必须用kubectl api-resources查询。metadata :元数据,主要是资源标识和说明,常用的有name、namespace、labels等。spec :描述,这是配置中最重要的一部分,里面是对各种资源配置的详细描述。status :状态信息,里面的内容不需要定义,由kubernetes自动生成。 在上面的属性中,spec是接下来研究的重点,继续看下它的常见子属性: containers <[]Object>:容器列表,用于定义容器的详细信息。nodeName :根据nodeName的值将Pod调度到指定的Node节点上。nodeSelector :根据NodeSelector中定义的信息选择该Pod调度到包含这些Label的Node上。hostNetwork :是否使用主机网络模式,默认为false,如果设置为true,表示使用宿主机网络。volumes <[]Object> :存储卷,用于定义Pod上面挂载的存储信息。restartPolicy :重启策略,表示Pod在遇到故障的时候的处理策略。 2 Pod的配置 2.1 概述 本小节主要来研究pod.spec.containers属性,这也是Pod配置中最为关键的一项配置。示例:查看pod.spec.containers的可选配置项 kubectl explain pod.spec.containers # 返回的重要属性KIND: PodVERSION: v1RESOURCE: containers <[]Object> # 数组,代表可以有多个容器FIELDS: name <string> # 容器名称 image <string> # 容器需要的镜像地址 imagePullPolicy <string> # 镜像拉取策略 command <[]string> # 容器的启动命令列表,如不指定,使用打包时使用的启动命令 args <[]string> # 容器的启动命令需要的参数列表 env <[]Object> # 容器环境变量的配置 ports <[]Object> # 容器需要暴露的端口号列表 resources <Object> # 资源限制和资源请求的设置 2.2 基本配置 创建pod-base.yaml文件,内容如下: apiVersion: v1kind: Podmetadata: name: pod-base namespace: dev labels: user: xudaxianspec: containers: - name: nginx # 容器名称 image: nginx:1.17.1 # 容器需要的镜像地址 - name: busybox # 容器名称 image: busybox:1.30 # 容器需要的镜像地址 上面定义了一个比较简单的Pod的配置,里面有两个容器: nginx:用的是1.17.1版本的nginx镜像创建(nginx是一个轻量级的web容器)。busybox:用的是1.30版本的busybox镜像创建(busybox是一个小巧的linux命令集合)。 创建Pod: kubectl apply -f pod-base.yaml 查看Pod状况: kubectl get pod -n dev 通过describe查看内部的详情: # 此时已经运行起来了一个基本的Pod,虽然它暂时有问题kubectl describe pod pod-base -n dev 2.3 镜像拉取策略 创建pod-imagepullpolicy.yaml文件,内容如下: apiVersion: v1kind: Podmetadata: name: pod-imagepullpolicy namespace: dev labels: user: xudaxianspec: containers: - name: nginx # 容器名称 image: nginx:1.17.1 # 容器需要的镜像地址 imagePullPolicy: Always # 用于设置镜像的拉取策略 - name: busybox # 容器名称 image: busybox:1.30 # 容器需要的镜像地址 imagePullPolicy:用于设置镜像拉取的策略,kubernetes支持配置三种拉取策略: Always:总是从远程仓库拉取镜像(一直远程下载)。IfNotPresent:本地有则使用本地镜像,本地没有则从远程仓库拉取镜像(本地有就用本地,本地没有就使用远程下载)。Never:只使用本地镜像,从不去远程仓库拉取,本地没有就报错(一直使用本地,没有就报错)。 默认值说明: 如果镜像tag为具体的版本号,默认策略是IfNotPresent。如果镜像tag为latest(最终版本),默认策略是Always。 创建Pod: kubectl apply -f pod-imagepullpolicy.yaml 查看Pod详情: kubectl describe pod pod-imagepullpolicy -n dev 2.4 启动命令 在前面的案例中,一直有一个问题没有解决,就是busybox容器一直没有成功运行,那么到底是什么原因导致这个容器的故障的呢?原来busybox并不是一个程序,而是类似于一个工具类的集合,kubernetes集群启动管理后,它会自动关闭。解决方法就是让其一直在运行,这就用到了command的配置。创建pod-command.yaml文件,内容如下: apiVersion: v1kind: Podmetadata: name: pod-command namespace: dev labels: user: xudaxianspec: containers: - name: nginx # 容器名称 image: nginx:1.17.1 # 容器需要的镜像地址 imagePullPolicy: IfNotPresent # 设置镜像拉取策略 - name: busybox # 容器名称 image: busybox:1.30 # 容器需要的镜像地址 command: ["/bin/sh","-c","touch /tmp/hello.txt;while true;do /bin/echo $(date +%T) >> /tmp/hello.txt;sleep 3;done;"] command:用于在Pod中的容器初始化完毕之后执行一个命令。 这里稍微解释下command中的命令的意思: “/bin/sh”,”-c”:使用sh执行命令。touch /tmp/hello.txt:创建一个/tmp/hello.txt的文件。while true;do /bin/echo $(date +%T) >> /tmp/hello.txt;sleep 3;done:每隔3秒,向文件写入当前时间 创建Pod: kubectl apply -f pod-command.yaml 查看Pod状态: kubectl get pod pod-command -n dev 进入Pod中的busybox容器,查看文件内容: # 在容器中执行命令# kubectl exec -it pod的名称 -n 命名空间 -c 容器名称 /bin/shkubectl exec -it pod-command -n dev -c busybox /bin/sh 特别说明:通过上面发现command已经可以完成启动命令和传递参数的功能,为什么还要提供一个args选项,用于传递参数?其实和Docker有点关系,kubernetes中的command和args两个参数其实是为了实现覆盖Dockerfile中的ENTRYPOINT的功能: 如果command和args均没有写,那么用Dockerfile的配置。如果command写了,但是args没有写,那么Dockerfile默认的配置会被忽略,执行注入的command。如果command没有写,但是args写了,那么Dockerfile中配置的ENTRYPOINT命令会被执行,使用当前args的参数。如果command和args都写了,那么Dockerfile中的配置会被忽略,执行command并追加上args参数。 2.5 环境变量(不推荐) 创建pod-evn.yaml文件,内容如下: apiVersion: v1kind: Podmetadata: name: pod-env namespace: dev labels: user: xudaxianspec: containers: - name: nginx # 容器名称 image: nginx:1.17.1 # 容器需要的镜像地址 imagePullPolicy: IfNotPresent # 设置镜像拉取策略 - name: busybox # 容器名称 image: busybox:1.30 # 容器需要的镜像地址 command: ["/bin/sh","-c","touch /tmp/hello.txt;while true;do /bin/echo $(date +%T) >> /tmp/hello.txt;sleep 3;done;"] env: - name: "username" value: "admin" - name: "password" value: "123456" env:环境变量,用于在Pod中的容器设置环境变量。 创建Pod: kubectl create -f pod-env.yaml 进入容器,输出环境变量: kubectl exec -it pod-env -n dev -c busybox -it /bin/sh 此种方式不推荐,推荐将这些配置单独存储在配置文件中,后面介绍。 2.6 端口设置 查看ports支持的子选项: kubectl explain pod.spec.containers.ports KIND: PodVERSION: v1RESOURCE: ports <[]Object>FIELDS: name <string> # 端口名称,如果指定,必须保证name在pod中是唯一的 containerPort <integer> # 容器要监听的端口(0<x<65536) hostPort <integer> # 容器要在主机上公开的端口,如果设置,主机上只能运行容器的一个副本(一般省略) hostIP <string> # 要将外部端口绑定到的主机IP(一般省略) protocol <string> # 端口协议。必须是UDP、TCP或SCTP。默认为“TCP” 创建pod-ports.yaml文件,内容如下: apiVersion: v1kind: Podmetadata: name: pod-ports namespace: dev labels: user: xudaxianspec: containers: - name: nginx # 容器名称 image: nginx:1.17.1 # 容器需要的镜像地址 imagePullPolicy: IfNotPresent # 设置镜像拉取策略 ports: - name: nginx-port # 端口名称,如果执行,必须保证name在Pod中是唯一的 containerPort: 80 # 容器要监听的端口 (0~65536) protocol: TCP # 端口协议 创建Pod: kubectl create -f pod-ports.yaml 访问Pod中的容器中的程序使用的是PodIp:containerPort。 2.7 资源配额 容器中的程序要运行,肯定会占用一定的资源,比如CPU和内存等,如果不对某个容器的资源做限制,那么它就可能吃掉大量的资源,导致其他的容器无法运行。针对这种情况,kubernetes提供了对内存和CPU的资源进行配额的机制,这种机制主要通过resources选项实现,它有两个子选项: limits:用于限制运行的容器的最大占用资源,当容器占用资源超过limits时会被终止,并进行重启。requests:用于设置容器需要的最小资源,如果环境资源不够,容器将无法启动。 可以通过上面的两个选项设置资源的上下限。创建pod-resoures.yaml文件,内容如下: apiVersion: v1kind: Podmetadata: name: pod-resoures namespace: dev labels: user: xudaxianspec: containers: - name: nginx # 容器名称 image: nginx:1.17.1 # 容器需要的镜像地址 imagePullPolicy: IfNotPresent # 设置镜像拉取策略 ports: # 端口设置 - name: nginx-port # 端口名称,如果执行,必须保证name在Pod中是唯一的 containerPort: 80 # 容器要监听的端口 (0~65536) protocol: TCP # 端口协议 resources: # 资源配额 limits: # 限制资源的上限 cpu: "2" # CPU限制,单位是core数 memory: "10Gi" # 内存限制 requests: # 限制资源的下限 cpu: "1" # CPU限制,单位是core数 memory: "10Mi" # 内存限制 cpu:core数,可以为整数或小数。 memory:内存大小,可以使用Gi、Mi、G、M等形式。 创建Pod: kubectl create -f pod-resource.yaml 查看发现Pod运行正常: kubectl get pod pod-resoures -n dev 接下来,停止Pod: kubectl delete -f pod-resource.yaml 编辑Pod,修改resources.requests.memory的值为10Gi: apiVersion: v1kind: Podmetadata: name: pod-resoures namespace: dev labels: user: xudaxianspec: containers: - name: nginx # 容器名称 image: nginx:1.17.1 # 容器需要的镜像地址 imagePullPolicy: IfNotPresent # 设置镜像拉取策略 ports: # 端口设置 - name: nginx-port # 端口名称,如果执行,必须保证name在Pod中是唯一的 containerPort: 80 # 容器要监听的端口 (0~65536) protocol: TCP # 端口协议 resources: # 资源配额 limits: # 限制资源的上限 cpu: "2" # CPU限制,单位是core数 memory: "10Gi" # 内存限制 requests: # 限制资源的下限 cpu: "1" # CPU限制,单位是core数 memory: "10Gi" # 内存限制 再次启动Pod: kubectl create -f pod-resource.yaml 查看Pod状态,发现Pod启动失败: kubectl get pod pod-resoures -n dev -o wide 查看Pod详情会发现,如下提示: kubectl describe pod pod-resoures -n dev 3 Pod的生命周期 3.1 概述 我们一般将Pod对象从创建到终止的这段时间范围称为Pod的生命周期,它主要包含下面的过程: Pod创建过程。运行初始化容器(init container)过程。运行主容器(main container): 容器启动后钩子(post start)、容器终止前钩子(pre stop)。容器的存活性探测(liveness probe)、就绪性探测(readiness probe)。 Pod终止过程。 在整个生命周期中,Pod会出现5种状态(相位),分别如下: 挂起(Pending):API Server已经创建了Pod资源对象,但它尚未被调度完成或者仍处于下载镜像的过程中。运行中(Running):Pod已经被调度到某节点,并且所有容器都已经被kubelet创建完成。成功(Succeeded):Pod中的所有容器都已经成功终止并且不会被重启。失败(Failed):所有容器都已经终止,但至少有一个容器终止失败,即容器返回了非0值的退出状态。未知(Unknown):API Server无法正常获取到Pod对象的状态信息,通常由于网络通信失败所导致。 3.2 创建和终止 3.2.1 Pod的创建过程 ① 用户通过kubectl或其他的api客户端提交需要创建的Pod信息给API Server。② API Server开始生成Pod对象的信息,并将信息存入etcd,然后返回确认信息至客户端。③ API Server开始反映etcd中的Pod对象的变化,其它组件使用watch机制来跟踪检查API Server上的变动。④ Scheduler发现有新的Pod对象要创建,开始为Pod分配主机并将结果信息更新至API Server。⑤ Node节点上的kubelet发现有Pod调度过来,尝试调度Docker启动容器,并将结果回送至API Server。⑥ API Server将接收到的Pod状态信息存入到etcd中。 3.2.2 Pod的终止过程 ① 用户向API Server发送删除Pod对象的命令。② API Server中的Pod对象信息会随着时间的推移而更新,在宽限期内(默认30s),Pod被视为dead。③ 将Pod标记为terminating状态。④ kubelete在监控到Pod对象转为terminating状态的同时启动Pod关闭过程。⑤ 端点控制器监控到Pod对象的关闭行为时将其从所有匹配到此端点的service资源的端点列表中移除。⑥ 如果当前Pod对象定义了preStop钩子处理器,则在其标记为terminating后会以同步的方式启动执行。⑦ Pod对象中的容器进程收到停止信号。⑧ 宽限期结束后,如果Pod中还存在运行的进程,那么Pod对象会收到立即终止的信号。⑨ kubectl请求API Server将此Pod资源的宽限期设置为0从而完成删除操作,此时Pod对于用户已经不可用了。 3.3 初始化容器 初始化容器是在Pod的主容器启动之前要运行的容器,主要是做一些主容器的前置工作,它具有两大特征: ① 初始化容器必须运行完成直至结束,如果某个初始化容器运行失败,那么kubernetes需要重启它直至成功完成。② 初始化容器必须按照定义的顺序执行,当且仅当前一个成功之后,后面的一个才能运行。 初始化容器有很多的应用场景,下面列出的是最常见的几个: 提供主容器镜像中不具备的工具程序或自定义代码。初始化容器要先于应用容器串行启动并运行完成,因此可用于延后应用容器的启动直至其依赖的条件得到满足。 接下来做一个案例,模拟下面这个需求: 假设要以主容器来运行Nginx,但是要求在运行Nginx之前要能够连接上MySQL和Redis所在的服务器。为了简化测试,事先规定好MySQL和Redis所在的IP地址分别为192.168.18.103和192.168.18.104(注意,这两个IP都不能ping通,因为环境中没有这两个IP)。 创建pod-initcontainer.yaml文件,内容如下: apiVersion: v1kind: Podmetadata: name: pod-initcontainer namespace: dev labels: user: xudaxianspec: containers: # 容器配置 - name: nginx image: nginx:1.17.1 imagePullPolicy: IfNotPresent ports: - name: nginx-port containerPort: 80 protocol: TCP resources: limits: cpu: "2" memory: "10Gi" requests: cpu: "1" memory: "10Mi" initContainers: # 初始化容器配置 - name: test-mysql image: busybox:1.30 command: ["sh","-c","until ping 192.168.18.103 -c 1;do echo waiting for mysql ...;sleep 2;done;"] securityContext: privileged: true # 使用特权模式运行容器 - name: test-redis image: busybox:1.30 command: ["sh","-c","until ping 192.168.18.104 -c 1;do echo waiting for redis ...;sleep 2;done;"] 创建Pod: kubectl create -f pod-initcontainer.yaml 查看Pod状态: kubectl describe pod pod-initcontainer -n dev 动态查看Pod: kubectl get pod pod-initcontainer -n dev -w 接下来,新开一个shell,为当前服务器(192.168.18.100)新增两个IP,观察Pod的变化: ifconfig ens33:1 192.168.18.103 netmask 255.255.255.0 up ifconfig ens33:2 192.168.18.104 netmask 255.255.255.0 up 3.4 钩子函数 钩子函数能够感知自身生命周期中的事件,并在相应的时刻到来时运行用户指定的程序代码。kubernetes在主容器启动之后和停止之前提供了两个钩子函数: post start:容器创建之后执行,如果失败会重启容器。pre stop:容器终止之前执行,执行完成之后容器将成功终止,在其完成之前会阻塞删除容器的操作。 钩子处理器支持使用下面的三种方式定义动作: ① exec命令:在容器内执行一次命令。 ……lifecycle:postStart: exec: command: - cat - /tmp/healthy…… ② tcpSocket:在当前容器尝试访问指定的socket。 …… lifecycle: postStart: tcpSocket: port: 8080…… ③ httpGet:在当前容器中向某url发起HTTP请求。 …… lifecycle: postStart: httpGet: path: / #URI地址 port: 80 #端口号 host: 192.168.109.100 #主机地址 scheme: HTTP #支持的协议,http或者https…… 接下来,以exec方式为例,演示下钩子函数的使用,创建pod-hook-exec.yaml文件,内容如下: apiVersion: v1kind: Podmetadata: name: pod-hook-exec namespace: dev labels: user: xudaxianspec: containers: # 容器配置 - name: nginx image: nginx:1.17.1 imagePullPolicy: IfNotPresent ports: - name: nginx-port containerPort: 80 protocol: TCP resources: limits: cpu: "2" memory: "10Gi" requests: cpu: "1" memory: "10Mi" lifecycle: # 生命周期配置 postStart: # 容器创建之后执行,如果失败会重启容器 exec: # 在容器启动的时候,执行一条命令,修改掉Nginx的首页内容 command: ["/bin/sh","-c","echo postStart ... > /usr/share/nginx/html/index.html"] preStop: # 容器终止之前执行,执行完成之后容器将成功终止,在其完成之前会阻塞删除容器的操作 exec: # 在容器停止之前停止Nginx的服务 command: ["/usr/sbin/nginx","-s","quit"] 创建Pod: kubectl create -f pod-hook-exec.yaml 查看Pod: kubectl get pod pod-hook-exec -n dev -o wide 访问Pod: curl 10.244.1.11 3.5 容器探测 3.5.1 概述 容器探测用于检测容器中的应用实例是否正常工作,是保障业务可用性的一种传统机制。如果经过探测,实例的状态不符合预期,那么kubernetes就会把该问题实例“摘除”,不承担业务流量。kubernetes提供了两种探针来实现容器探测,分别是: liveness probes:存活性探测,用于检测应用实例当前是否处于正常运行状态,如果不是,k8s会重启容器。readiness probes:就绪性探测,用于检测应用实例是否可以接受请求,如果不能,k8s不会转发流量。 livenessProbe:存活性探测,决定是否重启容器。 readinessProbe:就绪性探测,决定是否将请求转发给容器。 k8s在1.16版本之后新增了startupProbe探针,用于判断容器内应用程序是否已经启动。如果配置了startupProbe探针,就会先禁止其他的探针,直到startupProbe探针成功为止,一旦成功将不再进行探测。 上面两种探针目前均支持三种探测方式: ① exec命令:在容器内执行一次命令,如果命令执行的退出码为0,则认为程序正常,否则不正常。 ……livenessProbe:exec: command: - cat - /tmp/healthy…… ② tcpSocket:将会尝试访问一个用户容器的端口,如果能够建立这条连接,则认为程序正常,否则不正常。 ……livenessProbe: tcpSocket: port: 8080…… ③ httpGet:调用容器内web应用的URL,如果返回的状态码在200和399之前,则认为程序正常,否则不正常。 ……livenessProbe: httpGet: path: / #URI地址 port: 80 #端口号 host: 127.0.0.1 #主机地址 scheme: HTTP #支持的协议,http或者https…… 3.5.2 exec方式 创建pod-liveness-exec.yaml文件,内容如下: apiVersion: v1kind: Podmetadata: name: pod-liveness-exec namespace: dev labels: user: xudaxianspec: containers: # 容器配置 - name: nginx image: nginx:1.17.1 imagePullPolicy: IfNotPresent ports: - name: nginx-port containerPort: 80 protocol: TCP livenessProbe: # 存活性探针 exec: command: ["/bin/cat","/tmp/hello.txt"] # 执行一个查看文件的命令,必须失败,因为根本没有这个文件 创建Pod: kubectl create -f pod-liveness-exec.yaml 查看Pod详情: kubectl describe pod pod-liveness-exec -n dev 观察上面的信息就会发现nginx容器启动之后就进行了健康检查。检查失败之后,容器被kill掉,然后尝试进行重启,这是重启策略的作用。稍等一会之后,再观察Pod的信息,就会看到RESTARTS不再是0,而是一直增长。 查看Pod信息: kubectl get pod pod-liveness-exec -n dev 3.5.3 tcpSocket方式 创建pod-liveness-tcpsocket.yaml文件,内容如下: apiVersion: v1kind: Podmetadata: name: pod-liveness-tcpsocket namespace: dev labels: user: xudaxianspec: containers: # 容器配置 - name: nginx image: nginx:1.17.1 imagePullPolicy: IfNotPresent ports: - name: nginx-port containerPort: 80 protocol: TCP livenessProbe: # 存活性探针 tcpSocket: port: 8080 # 尝试访问8080端口,必须失败,因为Pod内部只有一个Nginx容器,而且只是监听了80端口 创建Pod: kubectl create -f pod-liveness-tcpsocket.yaml 查看Pod详情: kubectl describe pod pod-liveness-tcpsocket -n dev 观察上面的信息,发现尝试访问8080端口,但是失败了 稍等一会之后,再观察Pod的信息,就会看到RESTARTS不再是0,而是一直增长。 查看Pod信息: kubectl get pod pod-liveness-tcpsocket -n dev 3.5.4 httpGet方式 创建pod-liveness-httpget.yaml文件,内容如下: apiVersion: v1kind: Podmetadata: name: pod-liveness-httpget namespace: dev labels: user: xudaxianspec: containers: # 容器配置 - name: nginx image: nginx:1.17.1 imagePullPolicy: IfNotPresent ports: - name: nginx-port containerPort: 80 protocol: TCP livenessProbe: # 存活性探针 httpGet: # 其实就是访问http://127.0.0.1:80/hello port: 80 # 端口号 scheme: HTTP # 支持的协议,HTTP或HTTPS path: /hello # URI地址 host: 127.0.0.1 # 主机地址 创建Pod: kubectl create -f pod-liveness-httpget.yaml 查看Pod详情: kubectl describe pod pod-liveness-httpget -n dev 查看Pod信息: kubectl get pod pod-liveness-httpget -n dev 3.5.5 容器探测的补充 上面已经使用了livenessProbe演示了三种探测方式,但是查看livenessProbe的子属性,会发现除了这三种方式,还有一些其他的配置。 kubectl explain pod.spec.containers.livenessProbe FIELDS: exec tcpSockethttpGetinitialDelaySeconds # 容器启动后等待多少秒执行第一次探测 timeoutSeconds # 探测超时时间。默认1秒,最小1秒 periodSeconds # 执行探测的频率。默认是10秒,最小1秒 failureThreshold # 连续探测失败多少次才被认定为失败。默认是3。最小值是1 successThreshold # 连续探测成功多少次才被认定为成功。默认是1 3.6 重启策略 在容器探测中,一旦容器探测出现了问题,kubernetes就会对容器所在的Pod进行重启,其实这是由Pod的重启策略决定的,Pod的重启策略有3种,分别如下: Always:容器失效时,自动重启该容器,默认值。OnFailure:容器终止运行且退出码不为0时重启。Never:不论状态如何,都不重启该容器。 重启策略适用于Pod对象中的所有容器,首次需要重启的容器,将在其需要的时候立即进行重启,随后再次重启的操作将由kubelet延迟一段时间后进行,且反复的重启操作的延迟时长以此为10s、20s、40s、80s、160s和300s,300s是最大的延迟时长。创建pod-restart-policy.yaml文件,内容如下: apiVersion: v1kind: Podmetadata: name: pod-restart-policy namespace: dev labels: user: xudaxianspec: containers: # 容器配置 - name: nginx image: nginx:1.17.1 imagePullPolicy: IfNotPresent ports: - name: nginx-port containerPort: 80 protocol: TCP livenessProbe: # 存活性探测 httpGet: port: 80 path: /hello host: 127.0.0.1 scheme: HTTP restartPolicy: Never # 重启策略 创建Pod: kubectl create -f pod-restart-policy.yaml 查看Pod详情,发现nginx容器启动失败: kubectl describe pod pod-restart-policy -n dev 多等一会,观察Pod的重试次数,发现一直是0,并未重启。 查看Pod: kubectl get pod pod-restart-policy -n dev 4 Pod的调度 4.1 概述 在默认情况下,一个Pod在哪个Node节点上运行,是由Scheduler组件采用相应的算法计算出来的,这个过程是不受人工控制的。但是在实际使用中,这并不满足需求,因为很多情况下,我们想控制某些Pod到达某些节点上,那么应该怎么做?这就要求了解kubernetes对Pod的调度规则,kubernetes提供了四大类调度方式。 自动调度:运行在哪个Node节点上完全由Scheduler经过一系列的算法计算得出。定向调度:NodeName、NodeSelector。亲和性调度:NodeAffinity、PodAffinity、PodAntiAffinity。污点(容忍)调度:Taints、Toleration。 4.2 定向调度 4.2.1 概述 定向调度,指的是利用在Pod上声明的nodeName或nodeSelector,以此将Pod调度到期望的Node节点上。注意,这里的调度是强制的,这就意味着即使要调度的目标Node不存在,也会向上面进行调度,只不过Pod运行失败而已。 4.2.2 nodeName nodeName用于强制约束将Pod调度到指定的name的Node节点上。这种方式,其实是直接跳过Scheduler的调度逻辑,直接将Pod调度到指定名称的节点。创建一个pod-nodename.yaml文件,内容如下: apiVersion: v1kind: Podmetadata: name: pod-nodename namespace: dev labels: user: xudaxianspec: containers: # 容器配置 - name: nginx image: nginx:1.17.1 imagePullPolicy: IfNotPresent ports: - name: nginx-port containerPort: 80 protocol: TCP nodeName: k8s-node1 # 指定调度到k8s-node1节点上 创建Pod: kubectl create -f pod-nodename.yaml 查看Pod: kubectl get pod pod-nodename -n dev -o wide 4.2.3 nodeSelector nodeSelector用于将Pod调度到添加了指定标签的Node节点上,它是通过kubernetes的label-selector机制实现的,换言之,在Pod创建之前,会由Scheduler使用MatchNodeSelector调度策略进行label匹配,找出目标node,然后将Pod调度到目标节点,该匹配规则是强制约束。首先给node节点添加标签: kubectl label node k8s-node1 nodeenv=pro kubectl label node k8s-node2 nodeenv=test 创建pod-nodeselector.yaml文件,内容如下: apiVersion: v1kind: Podmetadata: name: pod-nodeselector namespace: devspec: containers: # 容器配置 - name: nginx image: nginx:1.17.1 imagePullPolicy: IfNotPresent ports: - name: nginx-port containerPort: 80 protocol: TCP nodeSelector: nodeenv: pro # 指定调度到具有nodeenv=pro的Node节点上 创建Pod: kubectl create -f pod-nodeselector.yaml 查看Pod: kubectl get pod pod-nodeselector -n dev -o wide 4.3 亲和性调度 4.3.1 概述 虽然定向调度的两种方式,使用起来非常方便,但是也有一定的问题,那就是如果没有满足条件的Node,那么Pod将不会被运行,即使在集群中还有可用的Node列表也不行,这就限制了它的使用场景。基于上面的问题,kubernetes还提供了一种亲和性调度(Affinity)。它在nodeSelector的基础之上进行了扩展,可以通过配置的形式,实现优先选择满足条件的Node进行调度,如果没有,也可以调度到不满足条件的节点上,使得调度更加灵活。Affinity主要分为三类: nodeAffinity(node亲和性):以Node为目标,解决Pod可以调度到那些Node的问题。podAffinity(pod亲和性):以Pod为目标,解决Pod可以和那些已存在的Pod部署在同一个拓扑域中的问题。podAntiAffinity(pod反亲和性):以Pod为目标,解决Pod不能和那些已经存在的Pod部署在同一拓扑域中的问题。 关于亲和性和反亲和性的使用场景的说明: 亲和性:如果两个应用频繁交互,那么就有必要利用亲和性让两个应用尽可能的靠近,这样可以较少因网络通信而带来的性能损耗。反亲和性:当应用采用多副本部署的时候,那么就有必要利用反亲和性让各个应用实例打散分布在各个Node上,这样可以提高服务的高可用性。 4.3.2 nodeAffinity 查看nodeAffinity的可选配置项: pod.spec.affinity.nodeAffinity requiredDuringSchedulingIgnoredDuringExecution Node节点必须满足指定的所有规则才可以,相当于硬限制 nodeSelectorTerms 节点选择列表 matchFields 按节点字段列出的节点选择器要求列表 matchExpressions 按节点标签列出的节点选择器要求列表(推荐) key 键 values 值 operator 关系符 支持Exists, DoesNotExist, In, NotIn, Gt, Lt preferredDuringSchedulingIgnoredDuringExecution 优先调度到满足指定的规则的Node,相当于软限制 (倾向) preference 一个节点选择器项,与相应的权重相关联 matchFields 按节点字段列出的节点选择器要求列表 matchExpressions 按节点标签列出的节点选择器要求列表(推荐) key 键 values 值 operator 关系符 支持In, NotIn, Exists, DoesNotExist, Gt, Lt weight 倾向权重,在范围1-100。 关系符的使用说明: - matchExpressions: - key: nodeenv # 匹配存在标签的key为nodeenv的节点 operator: Exists - key: nodeenv # 匹配标签的key为nodeenv,且value是"xxx"或"yyy"的节点 operator: In values: ["xxx","yyy"] - key: nodeenv # 匹配标签的key为nodeenv,且value大于"xxx"的节点 operator: Gt values: "xxx" 下面演示requiredDuringSchedulingIgnoredDuringExecution: 创建pod-nodeaffinity-required.yaml文件,内容如下: apiVersion: v1kind: Podmetadata:name: pod-nodeaffinity-requirednamespace: devspec:containers: # 容器配置- name: nginx image: nginx:1.17.1 imagePullPolicy: IfNotPresent ports: - name: nginx-port containerPort: 80 protocol: TCPaffinity: # 亲和性配置nodeAffinity: # node亲和性配置 requiredDuringSchedulingIgnoredDuringExecution: # Node节点必须满足指定的所有规则才可以,相当于硬规则,类似于定向调度 nodeSelectorTerms: # 节点选择列表 - matchExpressions: - key: nodeenv # 匹配存在标签的key为nodeenv的节点,并且value是"xxx"或"yyy"的节点 operator: In values: - "xxx" - "yyy" 创建Pod: kubectl create -f pod-nodeaffinity-required.yaml 查看Pod状态(运行失败): kubectl get pod pod-nodeaffinity-required -n dev -o wide 查看Pod详情(发现调度失败,提示node选择失败): kubectl describe pod pod-nodeaffinity-required -n dev 删除Pod: kubectl delete -f pod-nodeaffinity-required.yaml 修改pod-nodeaffinity-required.yaml文件,内容如下: apiVersion: v1kind: Podmetadata:name: pod-nodeaffinity-requirednamespace: devspec:containers: # 容器配置- name: nginx image: nginx:1.17.1 imagePullPolicy: IfNotPresent ports: - name: nginx-port containerPort: 80 protocol: TCPaffinity: # 亲和性配置nodeAffinity: # node亲和性配置 requiredDuringSchedulingIgnoredDuringExecution: # Node节点必须满足指定的所有规则才可以,相当于硬规则,类似于定向调度 nodeSelectorTerms: # 节点选择列表 - matchExpressions: - key: nodeenv # 匹配存在标签的key为nodeenv的节点,并且value是"xxx"或"yyy"的节点 operator: In values: - "pro" - "yyy" 再次创建Pod: kubectl create -f pod-nodeaffinity-required.yaml 再次查看Pod: kubectl get pod pod-nodeaffinity-required -n dev -o wide 下面演示preferredDuringSchedulingIgnoredDuringExecution: 创建pod-nodeaffinity-preferred.yaml文件,内容如下: apiVersion: v1kind: Podmetadata:name: pod-nodeaffinity-preferrednamespace: devspec:containers: # 容器配置- name: nginx image: nginx:1.17.1 imagePullPolicy: IfNotPresent ports: - name: nginx-port containerPort: 80 protocol: TCPaffinity: # 亲和性配置nodeAffinity: # node亲和性配置 preferredDuringSchedulingIgnoredDuringExecution: # 优先调度到满足指定的规则的Node,相当于软限制 (倾向) - preference: # 一个节点选择器项,与相应的权重相关联 matchExpressions: - key: nodeenv operator: In values: - "xxx" - "yyy" weight: 1 创建Pod: kubectl create -f pod-nodeaffinity-preferred.yaml 查看Pod: kubectl get pod pod-nodeaffinity-preferred -n dev -o wide nodeAffinity的注意事项: 如果同时定义了nodeSelector和nodeAffinity,那么必须两个条件都满足,Pod才能运行在指定的Node上。如果nodeAffinity指定了多个nodeSelectorTerms,那么只需要其中一个能够匹配成功即可。如果一个nodeSelectorTerms中有多个matchExpressions,则一个节点必须满足所有的才能匹配成功。如果一个Pod所在的Node在Pod运行期间其标签发生了改变,不再符合该Pod的nodeAffinity的要求,则系统将忽略此变化。 4.3.3 podAffinity podAffinity主要实现以运行的Pod为参照,实现让新创建的Pod和参照的Pod在一个区域的功能。PodAffinity的可选配置项: pod.spec.affinity.podAffinity requiredDuringSchedulingIgnoredDuringExecution 硬限制 namespaces 指定参照pod的namespace topologyKey 指定调度作用域 labelSelector 标签选择器 matchExpressions 按节点标签列出的节点选择器要求列表(推荐) key 键 values 值 operator 关系符 支持In, NotIn, Exists, DoesNotExist. matchLabels 指多个matchExpressions映射的内容 preferredDuringSchedulingIgnoredDuringExecution 软限制 podAffinityTerm 选项 namespaces topologyKey labelSelector matchExpressions key 键 values 值 operator matchLabels weight 倾向权重,在范围1-1 topologyKey用于指定调度的作用域,例如: 如果指定为kubernetes.io/hostname,那就是以Node节点为区分范围。如果指定为beta.kubernetes.io/os,则以Node节点的操作系统类型来区分。 演示requiredDuringSchedulingIgnoredDuringExecution。创建参照Pod过程: 创建pod-podaffinity-target.yaml文件,内容如下: apiVersion: v1kind: Podmetadata:name: pod-podaffinity-targetnamespace: devlabels:podenv: pro # 设置标签spec:containers: # 容器配置- name: nginx image: nginx:1.17.1 imagePullPolicy: IfNotPresent ports: - name: nginx-port containerPort: 80 protocol: TCPnodeName: k8s-node1 # 将目标pod定向调度到k8s-node1 创建参照Pod: kubectl create -f pod-podaffinity-target.yaml 查看参照Pod: kubectl get pod pod-podaffinity-target -n dev -o wide 创建Pod过程: 创建pod-podaffinity-requred.yaml文件,内容如下: apiVersion: v1kind: Podmetadata:name: pod-podaffinity-requrednamespace: devspec:containers: # 容器配置- name: nginx image: nginx:1.17.1 imagePullPolicy: IfNotPresent ports: - name: nginx-port containerPort: 80 protocol: TCPaffinity: # 亲和性配置podAffinity: # Pod亲和性 requiredDuringSchedulingIgnoredDuringExecution: # 硬限制 - labelSelector: matchExpressions: # 该Pod必须和拥有标签podenv=xxx或者podenv=yyy的Pod在同一个Node上,显然没有这样的Pod - key: podenv operator: In values: - "xxx" - "yyy" topologyKey: kubernetes.io/hostname 创建Pod: kubectl create -f pod-podaffinity-requred.yaml 查看Pod状态,发现没有运行: kubectl get pod pod-podaffinity-requred -n dev 查看Pod详情: kubectl get pod pod-podaffinity-requred -n dev 删除Pod: kubectl delete -f pod-podaffinity-requred.yaml 修改pod-podaffinity-requred.yaml文件,内容如下: apiVersion: v1kind: Podmetadata:name: pod-podaffinity-requrednamespace: devspec:containers: # 容器配置- name: nginx image: nginx:1.17.1 imagePullPolicy: IfNotPresent ports: - name: nginx-port containerPort: 80 protocol: TCPaffinity: # 亲和性配置podAffinity: # Pod亲和性 requiredDuringSchedulingIgnoredDuringExecution: # 硬限制 - labelSelector: matchExpressions: # 该Pod必须和拥有标签podenv=xxx或者podenv=yyy的Pod在同一个Node上,显然没有这样的Pod - key: podenv operator: In values: - "pro" - "yyy" topologyKey: kubernetes.io/hostname 再次创建Pod: kubectl create -f pod-podaffinity-requred.yaml 再次查看Pod: kubectl get pod pod-podaffinity-requred -n dev -o wide 4.3.4 podAntiAffinity podAntiAffinity主要实现以运行的Pod为参照,让新创建的Pod和参照的Pod不在一个区域的功能。其配置方式和podAffinity一样,此处不做详细解释。使用上个案例中的目标Pod: kubectl get pod -n dev -o wide 创建pod-podantiaffinity-requred.yaml文件,内容如下: apiVersion: v1kind: Podmetadata: name: pod-podantiaffinity-requred namespace: devspec: containers: # 容器配置 - name: nginx image: nginx:1.17.1 imagePullPolicy: IfNotPresent ports: - name: nginx-port containerPort: 80 protocol: TCP affinity: # 亲和性配置 podAntiAffinity: # Pod反亲和性 requiredDuringSchedulingIgnoredDuringExecution: # 硬限制 - labelSelector: matchExpressions: - key: podenv operator: In values: - "pro" topologyKey: kubernetes.io/hostname 创建Pod: kubectl create -f pod-podantiaffinity-requred.yaml 查看Pod: kubectl get pod -n dev -o wide 4.4 污点和容忍 4.4.1 污点(Taints) 前面的调度方式都是站在Pod的角度上,通过在Pod上添加属性,来确定Pod是否要调度到指定的Node上,其实我们也可以站在Node的角度上,通过在Node上添加污点属性,来决定是否运行Pod调度过来。Node被设置了污点之后就和Pod之间存在了一种相斥的关系,进而拒绝Pod调度进来,甚至可以将已经存在的Pod驱逐出去。污点的格式为:key=value:effect,key和value是污点的标签,effect描述污点的作用,支持如下三个选项: PreferNoSchedule:kubernetes将尽量避免把Pod调度到具有该污点的Node上,除非没有其他节点可以调度。NoSchedule:kubernetes将不会把Pod调度到具有该污点的Node上,但是不会影响当前Node上已经存在的Pod。NoExecute:kubernetes将不会把Pod调度到具有该污点的Node上,同时也会将Node上已经存在的Pod驱逐。 语法: 设置污点: kubectl taint node xxx key=value:effect 去除污点: kubectl taint node xxx key:effect- 去除所有污点: kubectl taint node xxx key- 查询所有节点的污点: wget -O jq https://github.com/stedolan/jq/releases/download/jq-1.6/jq-linux64 chmod +x ./jq cp jq /usr/bin 列出所有节点的污点方式一: kubectl get nodes -o json | jq '.items[].spec' 列出所有节点的污点方式二: kubectl get nodes -o json | jq '.items[].spec.taints' 查看指定节点上的污点: kubectl describe node 节点名称 接下来,演示污点效果: ① 准备节点k8s-node1(为了演示效果更加明显,暂时停止k8s-node2节点)。② 为k8s-node1节点设置一个污点:tag=xudaxian:PreferNoSchedule,然后创建Pod1(Pod1可以)。③ 修改k8s-node1节点的污点为:tag=xudaxian:NoSchedule,然后创建Pod2(Pod1可以正常运行,Pod2失败)。④ 修改k8s-node1节点的污点为:tag=xudaxian:NoExecute,然后创建Pod3(Pod1、Pod2、Pod3失败)。 为k8s-node1设置污点(PreferNoSchedule): kubectl taint node k8s-node1 tag=xudaxian:PreferNoSchedule 创建Pod1: kubectl run pod1 --image=nginx:1.17.1 -n dev 查看Pod: kubectl get pod pod1 -n dev -o wide 为k8s-node1取消污点(PreferNoSchedule),并设置污点(NoSchedule): kubectl taint node k8s-node1 tag:PreferNoSchedule- kubectl taint node k8s-node1 tag=xudaxian:NoSchedule 创建Pod2: kubectl run pod2 --image=nginx:1.17.1 -n dev 查看Pod: kubectl get pod pod1 -n dev -o wide kubectl get pod pod2 -n dev -o wide 为k8s-node1取消污点(NoSchedule),并设置污点(NoExecute): kubectl taint node k8s-node1 tag:NoSchedule- kubectl taint node k8s-node1 tag=xudaxian:NoExecute 创建Pod3: kubectl run pod3 --image=nginx:1.17.1 -n dev 查看Pod: kubectl get pod pod1 -n dev -o wide kubectl get pod pod2 -n dev -o wide kubectl get pod pod3 -n dev -o wide 使用kubeadm搭建的集群,默认就会给Master节点添加一个污点标记,所以Pod就不会调度到Master节点上。 4.4.2 容忍(Toleration) 上面介绍了污点的作用,我们可以在Node上添加污点用来拒绝Pod调度上来,但是如果就是想让一个Pod调度到一个有污点的Node上去,这时候应该怎么做?这就需要使用到容忍。 污点就是拒绝,容忍就是忽略,Node通过污点拒绝Pod调度上去,Pod通过容忍忽略拒绝。 容忍的详细配置: kubectl explain pod.spec.tolerations......FIELDS: key # 对应着要容忍的污点的键,空意味着匹配所有的键 value # 对应着要容忍的污点的值 operator # key-value的运算符,支持Equal和Exists(默认) effect # 对应污点的effect,空意味着匹配所有影响 tolerationSeconds # 容忍时间, 当effect为NoExecute时生效,表示pod在Node上的停留时间 当operator为Equal的时候,如果Node节点有多个Taint,那么Pod每个Taint都需要容忍才能部署上去。 当operator为Exists的时候,有如下的三种写法: 容忍指定的污点,污点带有指定的effect:容忍指定的污点,不考虑具体的effect:容忍一切污点(慎用): tolerations: # 容忍 - key: "tag" # 要容忍的污点的key operator: Exists # 操作符 effect: NoExecute # 添加容忍的规则,这里必须和标记的污点规则相同 tolerations: # 容忍 - key: "tag" # 要容忍的污点的key operator: Exists # 操作符 tolerations: # 容忍 - operator: Exists # 操作符 在上面的污点中,已经给k8s-node1打上了NoExecute的污点,此时Pod是调度不上去的,此时可以通过在Pod中添加容忍,将Pod调度上去。创建pod-toleration.yaml文件,内容如下: apiVersion: v1kind: Podmetadata: name: pod-toleration namespace: devspec: containers: # 容器配置 - name: nginx image: nginx:1.17.1 imagePullPolicy: IfNotPresent ports: - name: nginx-port containerPort: 80 protocol: TCP tolerations: # 容忍 - key: "tag" # 要容忍的污点的key operator: Equal # 操作符 value: "xudaxian" # 要容忍的污点的value effect: NoExecute # 添加容忍的规则,这里必须和标记的污点规则相同 创建Pod: kubectl create -f pod-toleration.yaml 查看Pod: kubectl get pod pod-toleration -n dev -o wide 5 临时容器 5.1 概述 临时容器是一种特殊的容器,该容器可以在现有的Pod中临时运行,以便完成我们发起的操作,比如故障排查。我们应该使用临时容器来检查服务,而不是用临时容器来构建应用程序。Pod是kubernetes集群进行管理的最小单元,由于Pod是一次性且可以替换的,因此Pod一旦被创建,就无法将容器加入到Pod中。而且,我们通常使用Deployment来删除并替换Pod。但是,有的时候我们需要检查现有Pod的状态,比如对难以复现的故障进行排查。在这些场景中,可以在现有Pod中运行临时容器来检查其状态并运行任意命令。 5.2 什么是临时容器? 临时容器和其他容器的不同之处在于,它们缺少对资源或执行的保证,并且永远不会自动重启,因此不适合用来构建应用程序。临时容器使用和常规容器相同的ContainerSpec来描述,但是许多字段是不兼容或者不允许的。 临时容器没有端口配置,因此像ports、livenessProbe、readinessProbe这样的字段是没有的。Pod的资源分配是不可变的,因此resources这样的配置临时容器也是没有的。…… 临时容器是使用ephemeralcontainers来进行创建的,而不是直接添加到pod.spec中,所以是无法使用kubectl edit来添加一个临时容器。和常规容器一样,将临时容器添加到Pod后,不能更改或删除临时容器。 5.3 临时容器的用途 当由于容器奔溃或容器镜像不包含调试工具而导致kubectl exec无用的时候,临时容器对于交互式故障排查非常有用。比如,像distroless 镜像允许用户部署最小的容器镜像,从而减少攻击面并减少故障和漏洞的暴露。由于distroless 镜像不包含Shell或任何的调试工具,因此很难单独使用kubectl exec命令进行故障排查。使用临时容器的时候,启用进程名字空间共享 很有帮助,可以查看其他容器中的进程。 5.4 临时容器的配置 目前来说,临时容器默认是关闭的。查看临时容器是否开启: kubelet -h | grep EphemeralContainers 在每个节点(不管Master节点还是Node节点)修改kubectl的参数: 注意:kubectl的启动文件的路径是/usr/lib/systemd/system/kubelet.service.d/10-kubeadm.conf vim /etc/sysconfig/kubelet # 修改增加--feature-gates EphemeralContainers=trueKUBELET_EXTRA_ARGS="--cgroup-driver=systemd --feature-gates EphemeralContainers=true"KUBE_PROXY_MODE="ipvs" vim /var/lib/kubelet/config.yaml apiVersion: kubelet.config.k8s.io/v1beta1authentication: anonymous: enabled: falsevim webhook: cacheTTL: 0s enabled: true x509: clientCAFile: /etc/kubernetes/pki/ca.crtauthorization: mode: Webhook webhook: cacheAuthorizedTTL: 0s cacheUnauthorizedTTL: 0sclusterDNS:- 10.96.0.10clusterDomain: cluster.localcpuManagerReconcilePeriod: 0sevictionPressureTransitionPeriod: 0sfileCheckFrequency: 0shealthzBindAddress: 127.0.0.1healthzPort: 10248httpCheckFrequency: 0simageMinimumGCAge: 0skind: KubeletConfigurationnodeStatusReportFrequency: 0snodeStatusUpdateFrequency: 0srotateCertificates: trueruntimeRequestTimeout: 0sstaticPodPath: /etc/kubernetes/manifestsstreamingConnectionIdleTimeout: 0ssyncFrequency: 0svolumeStatsAggPeriod: 0s# 修改部分featureGates: EphemeralContainers: true 加载配置文件重启kubelet: systemctl daemon-reload systemctl stop kubelet systemctl start kubelet 在Master节点修改kube-apiserver.yaml和kube-scheduler.yaml: vim /etc/kubernetes/manifests/kube-apiserver.yaml apiVersion: v1kind: Podmetadata: annotations: kubeadm.kubernetes.io/kube-apiserver.advertise-address.endpoint: 192.168.49.100:6443 creationTimestamp: null labels: component: kube-apiserver tier: control-plane name: kube-apiserver namespace: kube-systemspec: containers: - command: - kube-apiserver - --advertise-address=192.168.49.100 - --allow-privileged=true - --authorization-mode=Node,RBAC - --client-ca-file=/etc/kubernetes/pki/ca.crt - --enable-admission-plugins=NodeRestriction - --enable-bootstrap-token-auth=true - --etcd-cafile=/etc/kubernetes/pki/etcd/ca.crt - --etcd-certfile=/etc/kubernetes/pki/apiserver-etcd-client.crt - --etcd-keyfile=/etc/kubernetes/pki/apiserver-etcd-client.key - --etcd-servers=https://127.0.0.1:2379 - --insecure-port=0 - --kubelet-client-certificate=/etc/kubernetes/pki/apiserver-kubelet-client.crt - --kubelet-client-key=/etc/kubernetes/pki/apiserver-kubelet-client.key - --kubelet-preferred-address-types=InternalIP,ExternalIP,Hostname - --proxy-client-cert-file=/etc/kubernetes/pki/front-proxy-client.crt - --proxy-client-key-file=/etc/kubernetes/pki/front-proxy-client.key - --requestheader-allowed-names=front-proxy-client - --requestheader-client-ca-file=/etc/kubernetes/pki/front-proxy-ca.crt - --requestheader-extra-headers-prefix=X-Remote-Extra- - --requestheader-group-headers=X-Remote-Group - --requestheader-username-headers=X-Remote-User - --secure-port=6443 - --service-account-issuer=https://kubernetes.default.svc.cluster.local - --service-account-key-file=/etc/kubernetes/pki/sa.pub - --service-account-signing-key-file=/etc/kubernetes/pki/sa.key - --service-cluster-ip-range=10.96.0.0/12 - --tls-cert-file=/etc/kubernetes/pki/apiserver.crt - --tls-private-key-file=/etc/kubernetes/pki/apiserver.key # 修改部分 - --feature-gates=EphemeralContainers=true vim /etc/kubernetes/manifests/kube-scheduler.yaml apiVersion: v1kind: Podmetadata: creationTimestamp: null labels: component: kube-scheduler tier: control-plane name: kube-scheduler namespace: kube-systemspec: containers: - command: - kube-scheduler - --authentication-kubeconfig=/etc/kubernetes/scheduler.conf - --authorization-kubeconfig=/etc/kubernetes/scheduler.conf - --bind-address=127.0.0.1 - --kubeconfig=/etc/kubernetes/scheduler.conf - --leader-elect=true # 修改部分 - --feature-gates=EphemeralContainers=true 5.5 使用临时容器在线debug 创建一个nginx.yaml文件,内容如下: apiVersion: v1kind: Podmetadata: name: nginxspec: shareProcessNamespace: true # 这个配置非常重要,一定要配置 containers: - name: nginx image: nginx:1.17.1 创建Pod: kubectl apply -f nginx.yaml 创建ec.json文件,内容如下(注意:name是Pod的名称): { "apiVersion": "v1", "kind": "EphemeralContainers", "metadata": { "name": "nginx" }, "ephemeralContainers": [{ "command": [ "sh" ], "image": "busybox", "imagePullPolicy": "IfNotPresent", "name": "debugger", "stdin": true, "tty": true, "terminationMessagePolicy": "File" }]} 使用下面的命令更新已经运行的容器: kubectl replace --raw /api/v1/namespaces/default/pods/nginx/ephemeralcontainers -f ec.json 使用如下的命令查看新创建的临时容器的状态: kubectl describe pod nginx 可以使用如下的命令连接临时容器: kubectl exec -it nginx -c debugger -- sh kubectl attach -it nginx -c debugger 6 服务质量Qos 6.1 概述 kubernetes创建Pod的时候就会指定QoS。QoS分为如下的三类: ① Guaranteed。② Burstable。③ BestEffort。 6.2 Qos之Guaranteed 6.2.1 概述 对于 QoS 类为 Guaranteed 的 Pod: Pod 中的每个容器,包含初始化容器,必须指定内存请求和内存限制,并且两者要相等。Pod 中的每个容器,包含初始化容器,必须指定 CPU 请求和 CPU 限制,并且两者要相等。 6.2.2 应用示例 创建命名空间: kubectl create namespace qos-example 创建qos-demo.yaml文件,内容如下: vim qos-demo.yaml apiVersion: v1kind: Podmetadata:name: qos-demonamespace: qos-examplespec:containers:- name: qos-demo-ctr image: nginx resources: limits: memory: "200Mi" cpu: "700m" requests: memory: "200Mi" cpu: "700m" 创建Pod: kubectl create -f qos-demo.yaml 查看Pod详情: kubectl get pod qos-demo -n qos-example -o yaml 删除Pod: kubectl delete -f qos-demo.yaml 6.3 Qos之Burstable 6.3.1 概述 如果满足下面条件,将会指定 Pod 的 QoS 类为 Burstable: Pod 不符合 Guaranteed QoS 类的标准。Pod 中至少一个容器具有内存或 CPU 请求,但是值不相等。 6.3.2 应用示例 创建qos-demo-2.yaml文件,内容如下: vim qos-demo-2.yaml apiVersion: v1kind: Podmetadata:name: qos-demo-2namespace: qos-examplespec:containers:- name: qos-demo-2-ctr image: nginx resources: limits: memory: "200Mi" requests: memory: "100Mi" 创建Pod: kubectl create -f qos-demo-2.yaml 查看Pod详情: kubectl get pod qos-demo-2 -n qos-example -o yaml 删除Pod: kubectl delete -f qos-demo2.yaml 6.4 Qos之BestEffort 6.4.1 概述 对于 QoS 类为 BestEffort 的 Pod,Pod 中的容器必须没有设置内存和 CPU 限制或请求。 6.4.2 应用示例 创建qos-demo-3.yaml文件,内容如下: vim qos-demo-3.yaml apiVersion: v1kind: Podmetadata:name: qos-demo-3namespace: qos-examplespec:containers:- name: qos-demo-3-ctr image: nginx 创建Pod: kubectl create -f qos-demo-3.yaml 查看Pod详情: kubectl get pod qos-demo-3 -n qos-example -o yaml 删除Pod: kubectl delete -f qos-demo3.yaml 6.5 Qos的应用 一旦出现OOM,kubernetes为了保证服务的可用,会先删除QoS为BestEffort的Pod,然后删除QoS为Burstable的Pod,最后删除QoS为Guaranteed 的Pod。